Vibe CodingとSpec-Driven DevelopmentにLeanによる定理証明を組み込む

概要

Vibe Codingで動くものを探索し、Spec-Driven Developmentで作るべきものを正本へ明文化する。 この二つは、AIを使った開発の方法としてすでに広く知られている。

両方を組み合わせれば、実装の探索力と仕様の明確さを得られるように見える。 しかし、Specに「並行実行しても終端状態は一つだけ」と書き、そのテストが通ったとしても、モデルが許すすべての遷移順序で本当に成立するかはまだ分からない。

Specに書かれていることと、その規則から保証が論理的に導けることは別である。 この間にLeanによる定理証明を置く。

探索、仕様、証明という三つの軸

Vibe CodingとSpec-Driven Developmentは、異なる問いに答える。 そこへ定理証明を加えると、三つ目の問いを扱える。

軸 答える問い 次の反復に使う結果
探索(Vibe Coding) 何を作れるか 生成したコードの実行結果
仕様(Spec-Driven Development) 何を作るべきか Spec、実装、テストの差分
証明(Leanによる定理証明) その仕様から保証を導けるか 証明済みの保証、必要な前提、未解決の証明責務

三つの軸は独立した工程ではない。それぞれの結果をほかの軸へ戻し、必要な箇所を反復して見直す。

Vibe Codingは、動くものを探索する。 Spec-Driven Developmentは、採用する意図を正本として管理する。 Leanは、その意図を形式命題へ変換し、前提から結論が導けるかを検査する。

このうち証明の軸は、完成したコードへ最後に証明を付ける工程ではない。 Specを形式モデルと定理へ変換し、証明作業で見つかった前提、境界、過大な要求をSpecと実装へ戻す反復である。

プログラムとSpecに求める性能

この記事で扱う「性能」は、処理速度ではない。 プログラムとSpecが、要求をどこまで正確に扱えるかを指している。

プログラムの性能は、Specが要求した入力、状態、失敗、再試行、並行実行を扱う網羅性と、実装対応を確認した範囲で証明対象の不変条件を破らない完全性で評価する。

Specの性能は、同じ規則を一か所だけで定義する簡潔性、要求と境界条件を隠さない網羅性、採用した前提から必要な保証を矛盾なく導ける完全性で評価する。

Leanを導入しただけで、自然言語のSpecが自動的に完全になるわけではない。 状態、入力、遷移、前提、不変条件、事後条件を形式命題へ移す過程では、形式化の対象にした曖昧さをそのまま定理にできない。

たとえば「最新を返す」という要求には、時刻が同じ二件の順序が必要になる。 「成功する」という要求には、部分的に取得できた状態を成功に含めるかという判断が必要になる。 「必要最小限のロック」という要求には、何を同値な結果とみなし、どの実装候補と比較するかという基準が必要になる。

自然言語なら、これらを決めずに先へ進める。 順序や成功条件を定理の対象にするなら、形式的な定義が必要になる。

その制約がSpecを変える。

Specの性質 証明作業が返す問い 改善の形
簡潔性 同じ規則を複数の定理が別々に仮定していないか 共通の定義や不変条件へ集約する
網羅性 未定義の状態、失敗、境界、並行順序がないか 状態と遷移を列挙し、未決定事項を明示する
完全性 採用した前提から必要な結論を導けるか 強すぎる要求、足りない前提、両立しない規則を見直す

証明に失敗した原因は、Specだけにあるとは限らない。 形式モデルが要求を表していない場合、コードやSQLが不変条件を破る場合、補題や証明手続きが足りない場合もある。 原因を分類し、必要な修正を正しい場所へ戻すことまでが、定理証明の役割になる。

Vibe CodingとSpec-Driven Developmentから始める

Vibe Codingから始めた場合は、試作品から要求を回収する。 現行コードをそのまま規範へ昇格させず、利用者が必要とする振る舞い、互換性による制約、偶然の実装、未決定事項を分けてspec.mdへ移す。

Specから始めた場合は、要求を実装へ渡す前に、状態遷移や不変条件を証明責務として取り出せる。 GitHub Spec Kitが示すSpec、Plan、Tasks、Implementの流れに、Specと形式モデルの往復を加える形である。

入口がどちらでも、合流後の構造は変わらない。

Vibe Coding ─→ 試作品 ───────┐
                              ├─→ spec.md ⇄ 形式モデル ⇄ Leanの定理
Spec-Driven Development ──────┘       ↑                         │
                                      └─ 前提と境界の見直し ─────┘

spec.md ─→ テスト要求 ─→ テスト
Leanの定理 ─→ 実装対応契約 ─→ コードとSQL

この構造では、Specが要求の正本になる。 Leanのモデルと定理はSpecから導いた検証資産であり、Specを上書きしない。 一方、証明で必要になった前提や境界は、形式モデルだけに閉じ込めずSpecへ戻す。

テストと定理証明の役割分担

定理証明を導入しても、Spec内のテスト項目は減らない。 テストと定理は、異なる範囲を検査するからである。

Leanは、定理が量化したモデル内の状態を扱う。 テストは、PythonやPostgreSQLの実装、外部サービス、設定、実行環境を具体的に扱う。 実装対応契約は、抽象的な定理が対象とする構造と、コードやSQLの構造を結ぶ。

spec.mdのテスト項目には安定した識別子を与え、要求、事前条件、操作、期待結果、境界条件を対応付ける。 正常系だけでなく、失敗、再試行、並行実行、権限違反、互換性も対象にする。

現在のリリースで必須となるテストと、将来追加したい候補は分離する。 必須項目へ未実施の候補を混ぜると、どこまで満たせば現在の要求が成立するのかを判定できなくなる。

「証明済み」が保証する範囲

Leanの公式文書が説明するように、Leanはソフトウェアやシステムに関する主張を数学的に精密な形へ変換し、その証明を検査できる。 しかし、Leanが受理するのは書かれた形式命題である。

「Leanで証明できたので、Specに必要な要求がすべて含まれている」という結論は導けない。 証明結果の保証範囲は、明示したモデル、前提、定理の量化範囲に限定される。

Lean公式リファレンスの証明検証に関する説明も、形式命題が意図した非形式的な意味に対応していることを別途確認する必要があると説明している。 抽象モデルを証明しても、PythonやPostgreSQLの実装をそのまま証明したことにはならない。

そこで、Specと形式命題の意味対応を人が確認し、定理と実装の間を実装対応契約、SQL検査、単体テスト、結合テストでつなぐ。 開発全体の保証は一つの証拠に委ねず、異なる証拠の範囲と境界を追跡できるようにする。

Lean 4を開発プロセスへ組み込んだ事例

私は、外部データを継続的に取得し、加工、保存、公開するバックエンドへ、Lean 4による定理証明を組み込んだ。 そこで得た答えは、不要な実装を削る場合だけでなく、安全のために保護を残す理由を明文化する場合にも現れた。

取得結果の重複登録

取得結果を重複なく登録する処理では、既存レコードを得るために同じ値でUPDATEしていた。 形式化して二つの方式を比較すると、このUPDATEは論理結果を変えない余分な書込みだと分かった。

そこで、競合時にはON CONFLICT DO NOTHING RETURNINGとキーの完全一致SELECTを使い、同じ値を書き戻さない実装へ変更した。 別の制約に包含されていたUNIQUE制約を削除し、読取り処理から応答にも検証にも使わない列を除いた。

この例が改善したのは処理速度ではない。 要求に必要な状態変更と実装上の偶然を分離し、その判断をSpec、データベーススキーマ、コード、テストへ戻すことで、Specと実装の対応を簡潔にした。

変換処理のロック範囲

同じ対象を変換して公開する処理では、ロックをどこまで保持するかが問題になった。 形式化すると、現行ロックの保持区間は、結果をコミットするだけなら必要となる区間より長かった。

しかし、入力を解決する処理と結果を生成する処理には、純粋性、再実行可能性、並行安全性の契約がなかった。 この前提では、ロックをコミット部分だけへ狭めても同じ結果になるとは証明できない。

そこで、入力解決から成果物の準備と公開までを直列化する方式を、安全側の現行契約としてSpecへ記載した。 定理証明は、実装を小さくするだけでなく、小さくできない理由と、小さくするために必要な契約も明らかにした。

部分取得と状態遷移

外部データの定期取得では、一部しか取得できない実行も成功として保持する必要があった。 一方で、許可していない状態遷移は拒否しなければならない。

この二つを同じ「完了」の意味に押し込まず、取得量に関するプロダクト判断と、状態遷移の安全性に分けた。 競合する二つの終端遷移が同時に確定しないことと、一回分のスナップショットを全件保存または全件ロールバックすることを証明した。

公開については、指定したスナップショットの収集処理が最新の履歴で完了し、データ一式が整合している場合だけ許可した。 内部で保持する任意の補助JSONを変更しても公開可否、順位、項目集合が変わらず、公開結果にも補助JSONを含めない性質を分けて証明した。

既存の「完了」の意味を維持し、取得量を表す補助状態を追加せず、取得の成否、遷移の合法性、保存の原子性、公開情報の範囲を別々の要求としてSpec、書込み処理、読取り処理、テストへ反映した。

Spec変更とCI

Lean 4の証明をCIへ組み込む過程では、既存アプリケーションの結論を覆す新しい不具合は見つからなかった。 一方、定理文の読取り、実装との対応検査、依存公理の監査には見逃し得る箇所が見つかり、証明を受け入れる仕組み自体も検査対象になった。

現在は、追跡対象のSpecファイルが変わるとCIを失敗させている。 人がSpecと形式命題の意味対応を確認するまで、生成処理やCIは変更を自動承認しない。

この仕組みは、Spec変更へ自動追随するためのものではない。 Spec、定理、登録済みの実装対応契約の追随漏れを見逃さないためのものである。

証明後のSpecレビュー

証明後にSpecを読み直すと、コードレビューとは異なる改善候補が見つかる。 実際に読み直すと、同じ要求の重複、廃止済み設計と現行規範の混在、必須テストと将来候補の混在が見つかった。

「最小権限」や「最小ロック」という表現が、実際の証明範囲より広い箇所もあった。 抽象的なアルゴリズムは証明済みでも、具体的な書込み処理やシリアライザとの対応証拠が足りない箇所もあった。

これらは、LeanがSpecの文章を自動的に添削して見つけた問題ではない。 定理の前提、結論、量化範囲を基準に人がSpecを再検査したため、重複、欠落、過大な保証を区別できた。

Specの簡潔性は、文字数を減らすことではない。 一つの規則を一つの正本に置き、証明、実装、テストから同じ規則を参照できる状態である。

Lean 4の段階的な導入

すべてのコードを形式化してから始める必要はない。 状態遷移、トランザクション、並行実行、再試行、権限、公開情報など、誤りの影響が大きく、具体例だけでは組合せを覆いにくい箇所を一つ選ぶ。

  1. spec.mdへ状態、失敗、禁止事項、テスト項目を書く。
  2. 守るべき不変条件を一つ選び、Leanの命題にする。
  3. 証明作業で判明した前提と境界を、Spec、コード、テストへ戻す。
  4. 定理とコードを実装対応契約で結び、Specや実装の変更検出をCIへ入れる。

Vibe Codingから始めた場合も、Specから始めた場合も、この四段階へ合流できる。 定理証明は、実装の後ろへ置くのではなく、Specと実装の間に組み込む。

探索、仕様、証明をつなぐ

Vibe Codingで、コードは動いた。 Spec-Driven Developmentで、そのコードが何を満たすべきかも残った。

Leanによる定理証明を組み込むと、採用した前提からどの保証を導けるか、その保証がどの実装とテストに対応するかまで残せる。 選んだ例の外側を扱える範囲も、まだ扱えていない範囲も見える。

Vibe Codingで探索し、Spec-Driven Developmentで意図を正本として管理し、Leanでその意図から保証が導けるかを確かめる。 三つの軸を一つの開発プロセスに組み込むことで、プログラムの網羅性と完全性、Specの簡潔性、網羅性、完全性を同じ開発の中で改善できる。

参考資料

RTX PRO 6000 Blackwell 2基でのLLM推論性能 - DS4Spark 320K-640K Long-context Scaling

注意

この記事は実際の実験データを元にLLMが生成したものです。

文体にAI臭がありますが、データは実際のものに基づいています。

概要

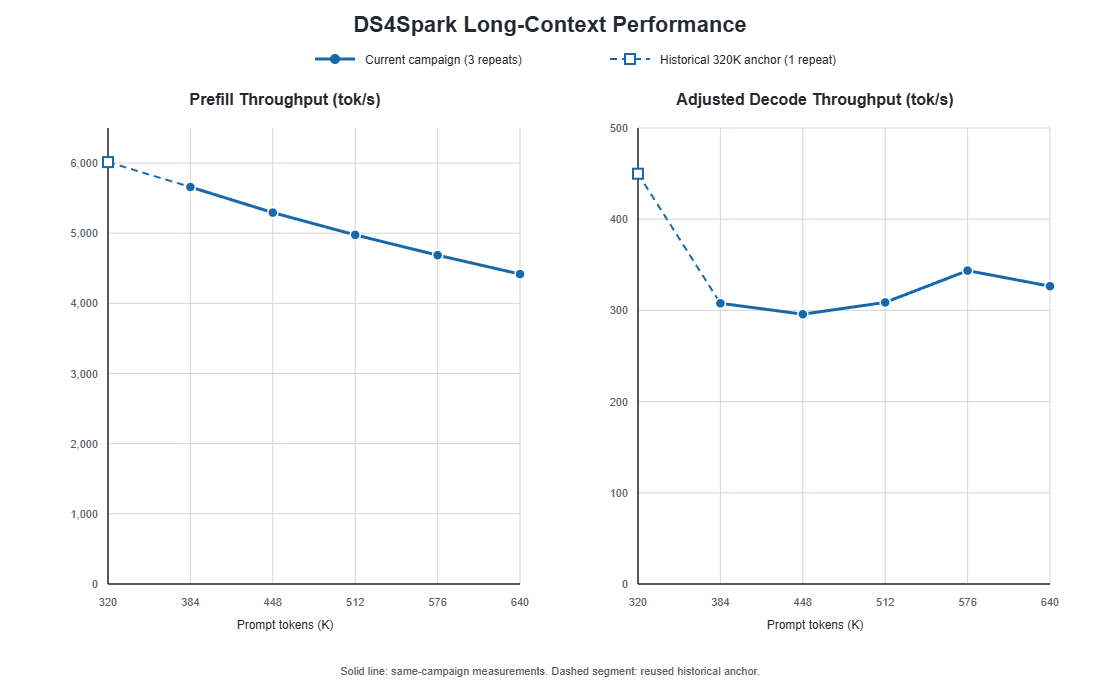
RTX PRO 6000 Blackwell Max-Q 2枚で、DeepSeek-V4-Flash-DSparkの入力長を320Kから640Kまで拡張した。

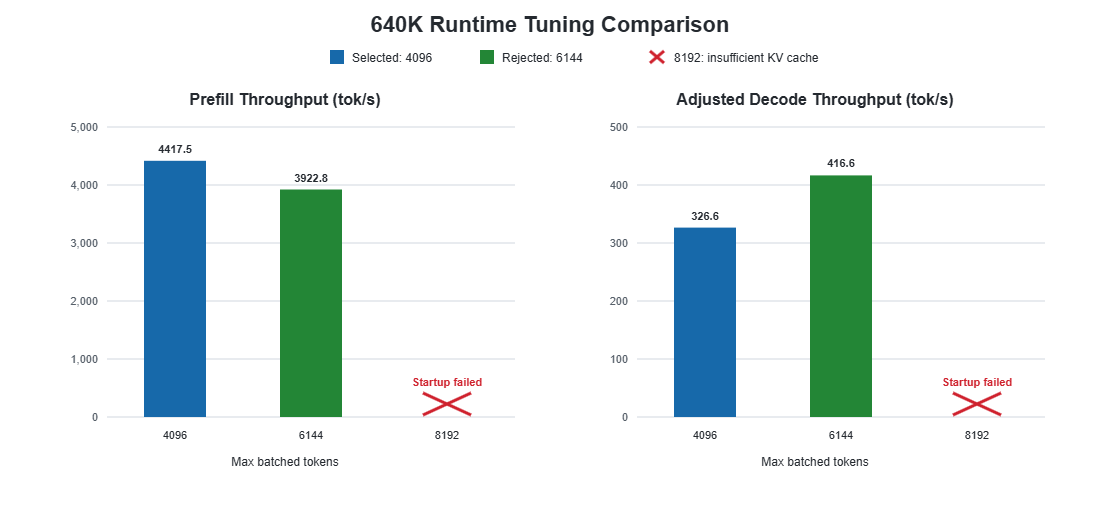
640K入力と512-token出力を3回完走し、prefill 4417.45 tok/s、補正decode 326.57 tok/sを得た。

Environment

  • GPU: NVIDIA RTX PRO 6000 Blackwell Max-Q 96 GB x2
  • Parallelism: tensor parallel 2
  • Runtime image: voipmonitor/vllm:fathomless-firmament-ds4-v10-vllmadf15ca-b12x90172a5-fi2cba2f7-cu132-20260712
  • Image digest: sha256:4f07aefe2aa15f66d5fd90580eaa2553926aea0c3fa46bc227610e90c668c9f0
  • Model: deepseek-ai/DeepSeek-V4-Flash-DSpark
  • Model revision: 913f0657a874f76844e2e91cbe706dbcaceeb6d7
  • Model config.json SHA-256: 6c8f3d2d3b48707541b88f32f22ef3f0f8a6b57d8523281e2b8d3cdb0ae9a023
  • Backend: FlashInfer sparse MLA for DSv4 and Lucifer CUTLASS MoE
  • KV cache: FP8

Method

320Kは同じimage digest、model revision、主要起動パラメーターで取得済みの結果を再利用した。

384Kから640Kは64K間隔で新たに測定し、各点でprefillと640K+512形式のlong decodeを3回実行した。

補正decodeは、long-decode総時間から同runのprefill中央値に基づく推定prefill時間を差し引いて算出した。

320Kは1回測定かつwarm-cache起動であるため、起動時間と分散は今回の系列と直接比較しない。

実線は今回同一campaignで測定した384Kから640K、白抜き点と破線は過去から再利用した320K anchorを示す。

Results

input actual prompt prefill tok/s adjusted decode tok/s short decode tok/s KV tokens KV concurrency repeats
320K 320,018 6,014.15 449.91 292.89 703,982 2.15x 1
384K 384,018 5,659.62 307.79 276.46 794,308 2.02x 3
448K 448,018 5,294.75 295.80 276.54 873,410 1.90x 3
512K 512,018 4,975.50 308.78 279.41 943,338 1.80x 3
576K 576,018 4,686.94 343.66 293.78 1,004,957 1.70x 3
640K 640,018 4,417.45 326.57 293.28 1,059,560 1.62x 3

384K以降の隣接点でprefill低下率は約5.7%から6.5%で、10%を超える性能断崖は見られなかった。

640Kのend-to-end output throughputはprefill時間を含めて3.496 tok/sである。

Tuning

max_num_batched_tokensだけを4096から6144、8192へ変更した。

max batched status prefill tok/s change adjusted decode tok/s change KV concurrency
4096 selected 4,417.45 baseline 326.57 baseline 1.62x
6144 rejected 3,922.81 -11.20% 416.62 +27.57% 1.19x
8192 startup failed - - - - -

6144はdecodeを改善したが、prefillが許容幅5%を超えて悪化し、KV余力も低下したため採用しなかった。

8192は利用可能KV cache 8.72 GiBに対して9.46 GiBが必要となり、vLLMが起動前に停止した。

既存の320K比較では投機深度5が短文decodeを41.70 tok/sまで悪化させ、深度3で292.89 tok/sへ改善している。

このため、投機深度を再び増やす探索は行わなかった。

Selected profile

640Kでは次の設定を使用する。

mode=dspark
backend=lucifer-cutlass
tensor_parallel_size=2
max_model_len=655360
max_num_batched_tokens=4096
max_num_seqs=1
gpu_memory_utilization=0.96
enable_prefix_caching=false
kv_cache_dtype=fp8
load_format=instanttensor
num_speculative_tokens=3
decode_tokens=512

Exact reproduction

次のコマンドは、採用した640K profileのコンテナを再現する。

実測時はimage tagを指定したが、再実行時の内容が変化しないように、ここではそのtagが実測時に解決したdigestを直接指定する。

REMOTE_ROOT=/home/ai-agent/llm-server-sm120-benchmark
IMAGE='voipmonitor/vllm@sha256:4f07aefe2aa15f66d5fd90580eaa2553926aea0c3fa46bc227610e90c668c9f0'
HOST_HF="$REMOTE_ROOT/models/hf"
CASE_NAME='dspark-lucifer-cutlass-controlled-pc0-len655360-batch4096'
CACHE="$REMOTE_ROOT/runtime-cache/rtx6kpro-v10/$CASE_NAME"
TMP="$REMOTE_ROOT/tmp/step53-ds4spark-640k-reproduction"
NAME='ds4spark-640k-reproduction'

mkdir -p "$CACHE" "$TMP/container-tmp"

docker run -d \
  --name "$NAME" \
  --gpus all \
  --runtime nvidia \
  --ipc host \
  --shm-size 32g \
  --network host \
  --init \
  --cpuset-cpus 0-15 \
  --cpuset-mems 0 \
  --ulimit memlock=-1 \
  --ulimit stack=67108864 \
  --ulimit nofile=1048576:1048576 \
  -v "$HOST_HF:/root/.cache/huggingface:ro" \
  -v "$CACHE:/cache:rw" \
  -v "$TMP/container-tmp:/container-tmp:rw" \
  -e CUDA_VISIBLE_DEVICES=0,1 \
  -e VLLM_HOST_IP=127.0.0.1 \
  -e GLOO_SOCKET_IFNAME=lo \
  -e NCCL_SOCKET_IFNAME=lo \
  -e TMPDIR=/container-tmp \
  -e MODE=dspark \
  -e STANDARD_MODEL=/root/.cache/huggingface/hub/models--deepseek-ai--DeepSeek-V4-Flash/snapshots/6976c7ff1b30a1b2cb7805021b8ba4684041f136 \
  -e MODEL_PATH= \
  -e SERVED_MODEL_NAME= \
  -e DSPARK_MODEL=/root/.cache/huggingface/models--deepseek-ai--DeepSeek-V4-Flash-DSpark/snapshots/913f0657a874f76844e2e91cbe706dbcaceeb6d7 \
  -e BACKEND=lucifer-cutlass \
  -e PORT=8100 \
  -e TP_SIZE=2 \
  -e DCP_SIZE=1 \
  -e MAX_NUM_SEQS=1 \
  -e MAX_MODEL_LEN=655360 \
  -e MAX_NUM_BATCHED_TOKENS=4096 \
  -e PREFIX_CACHE=0 \
  -e GPU_MEMORY_UTILIZATION=0.96 \
  -e ALLREDUCE_MODE=b12x \
  -e B12X_PCIE_DMA=0 \
  -e INDEXER_BACKEND=auto \
  -e CUDAGRAPH_CAPTURE_SIZES=default \
  -e ENABLE_FLASHINFER_AUTOTUNE=1 \
  -e DSPARK_TOKENS=3 \
  -e LOAD_FORMAT=instanttensor \
  -e INSTANTTENSOR_BACKEND=BUFFERED \
  --entrypoint /usr/local/bin/serve-ds4-flash.sh \
  "$IMAGE"

モデルはホストの次のsnapshotに配置し、コンテナへread-onlyでmountする。

/home/ai-agent/llm-server-sm120-benchmark/models/hf/models--deepseek-ai--DeepSeek-V4-Flash-DSpark/snapshots/913f0657a874f76844e2e91cbe706dbcaceeb6d7

起動完了はOpenAI互換APIで確認する。

初回起動はAOT compileを含むため、測定ハーネスは最大3600秒待機し、ready検出後に20秒待ってから負荷を開始する。

until curl -fsS http://127.0.0.1:8100/v1/models >/dev/null; do
  sleep 5
done
sleep 20

上記image内の /usr/local/bin/serve-ds4-flash.sh は、指定した環境変数を次の vllm serve argvへ展開する。

これはランチャーを DRY_RUN=1 で実行して取得した最終形であり、ランチャーが明示したvLLM optionをすべて記載している。

vLLM自体のdefault値はimage digestにより固定される。

vllm serve \
  /root/.cache/huggingface/models--deepseek-ai--DeepSeek-V4-Flash-DSpark/snapshots/913f0657a874f76844e2e91cbe706dbcaceeb6d7 \
  --served-model-name DeepSeek-V4-Flash-DSpark \
  --host 0.0.0.0 \
  --port 8100 \
  --trust-remote-code \
  --kv-cache-dtype fp8 \
  --block-size 256 \
  --load-format instanttensor \
  --tensor-parallel-size 2 \
  --decode-context-parallel-size 1 \
  --gpu-memory-utilization 0.96 \
  --max-model-len 655360 \
  --max-num-seqs 1 \
  --max-num-batched-tokens 4096 \
  --max-cudagraph-capture-size 6 \
  --compilation-config '{"cudagraph_mode":"FULL_AND_PIECEWISE","custom_ops":["all"]}' \
  --async-scheduling \
  --no-scheduler-reserve-full-isl \
  --enable-chunked-prefill \
  --tokenizer-mode deepseek_v4 \
  --tool-call-parser deepseek_v4 \
  --reasoning-parser deepseek_v4 \
  --enable-auto-tool-choice \
  --enable-prompt-tokens-details \
  --enable-force-include-usage \
  --enable-request-id-headers \
  --default-chat-template-kwargs.thinking=true \
  --default-chat-template-kwargs.reasoning_effort=high \
  --enable-flashinfer-autotune \
  --no-enable-prefix-caching \
  --speculative-config '{"model":"/root/.cache/huggingface/models--deepseek-ai--DeepSeek-V4-Flash-DSpark/snapshots/913f0657a874f76844e2e91cbe706dbcaceeb6d7","method":"dspark","num_speculative_tokens":3,"draft_sample_method":"probabilistic","rejection_sample_method":"standard"}' \
  --attention-backend FLASHINFER_MLA_SPARSE_DSV4 \
  --kernel-config.moe_backend flashinfer_cutlass

ALLREDUCE_MODE=b12x はimage内で VLLM_ENABLE_PCIE_ALLREDUCE=1、VLLM_PCIE_ALLREDUCE_BACKEND=b12x、VLLM_PCIE_ONESHOT_ALLREDUCE_MAX_SIZE=64KB、VLLM_USE_B12X_PCIE_DMA=0へ展開される。

ランチャーはSM120向けに CUTE_DSL_ARCH=sm_120a、NCCL_IB_DISABLE=1、NCCL_P2P_LEVEL=SYS、NCCL_PROTO=LL,LL128,Simple、OMP_NUM_THREADS=16、VLLM_USE_AOT_COMPILE=1、VLLM_USE_MEGA_AOT_ARTIFACT=1、VLLM_USE_FLASHINFER_SAMPLER=1も設定する。

これらの内部環境変数はimage digestで固定されたランチャーの一部であり、上記Docker commandを使う場合は別途指定しない。

プロジェクトのハーネスから同じ640K workloadを再実行する場合は、project rootで次を実行する。

STEP53_ACTION=run-point \
STEP53_POINT=640K \
STEP53_DSPARK_TOKENS=3 \
STEP53_MAX_BATCHED=4096 \
STEP53_GPU_MEMORY_UTILIZATION=0.96 \
./steps/053-ds4spark-long-context-scaling-tuning/commands.sh

このハーネスは640,000-token targetのprefillを3回、同じ長さから512 tokensを生成するlong decodeを3回実行し、runごとにcontainerを削除する。

手動起動したcontainerを停止するときは次を実行する。

docker logs "$NAME" >"$TMP/server.log" 2>&1
docker rm -f "$NAME"

RTX PRO 6000 Blackwell 2基でのLLM推論性能 - 様々なモデル

注意

この記事は実際の実験データを元にLLMが生成したものです。

文体にAI臭がありますが、データは実際のものに基づいています。

概要

2026年7月9日から27日まで、SM120のRTX PRO 6000 Blackwell Max-Qを2基搭載したサーバーで、6系統のLLMについて互換性、長コンテキスト、推論性能を測定した。

モデルごとに測定条件が異なるため、本稿ではモデル間の単純な順位ではなく、各モデルで到達した入力長、性能、起動条件を示す。

測定値とグラフの読み方

PFはprefill tokens/s、Decodeは生成tokens/s、Aggregateは並列リクエストの合計生成tokens/s、E2Eはprefill時間を含むoutput tokens/sを表す。

Adjusted DecodeはMTPで得たaccepted tokenを含む実効生成速度であり、通常のDecodeとは別の指標である。

表の「測定数」は同条件で取得した値の数であり、平均値または中央値を掲載する場合はその統計方法を明記した。

評価環境

項目 構成
マザーボード Gigabyte MC62-G40
GPU NVIDIA RTX PRO 6000 Blackwell Max-Q 2基、SM120
GPUメモリー 97,887 MiB/GPU、合計 195,774 MiB
GPU電力上限 250 W/GPU
GPU間接続 PCIe、nvidia-smi topo -mではNODE、NVLinkなし
CPU AMD Ryzen Threadripper PRO 3975WX、32コア64スレッド
RAM 256 GiB
OS Ubuntu 24.04.4 LTS、Linux 6.8.0-134-generic
NVIDIA Driver 595.71.05、CUDA 13.2
Docker 29.6.1、nvidia-container-cli 1.19.1
モデル配置 ホストへ保存し、Dockerへread-only bind mount

実測した入力長の上限

モデル 最大入力 最大条件 運用上の扱い
Gemma-4-31B-IT-NVFP4 261,657 入力と256出力を262,144以内に収容 10KはTP1を2プロセス、長文はTP2
Qwen3.6-35B-A3B-NVFP4 261,637 入力と256出力を262,144以内に収容 10KはTP1を2プロセス、長文はTP2
MiMo-V2.5-NVFP4 262,000 target 160K以上はtext-only 80Kは通常生成、長文はtext-only
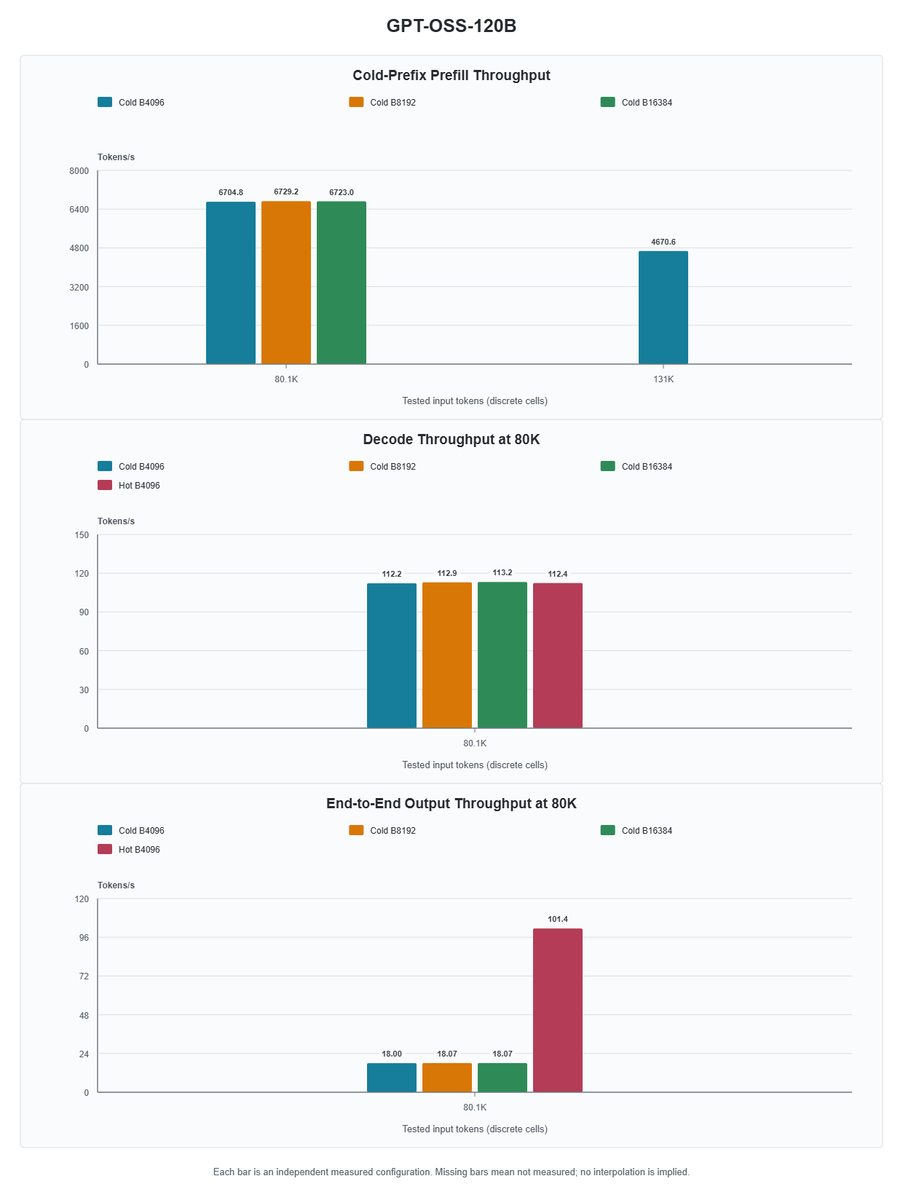
GPT-OSS-120B 131,030 16出力を含め131,046、上限まで26 tokens 80Kはcoldとhotを分離して測定
DeepSeek-V4-Flash NVFP4 1,047,519 512出力を含め1,048,576以内に収容 短文、524K、約1Mで構成を変更
DeepSeek-V4-Flash DS4Spark 320,000 target max_model_len=327680 320Kまで実測
Hy3 W4A16 40,005 40Kまで実測 再起動調査後に使用停止
Hy3 IQ1_M 1Bit 261,887 total context 262,144 W4A16とは別モデル、使用停止

Gemma-4-31B-IT-NVFP4

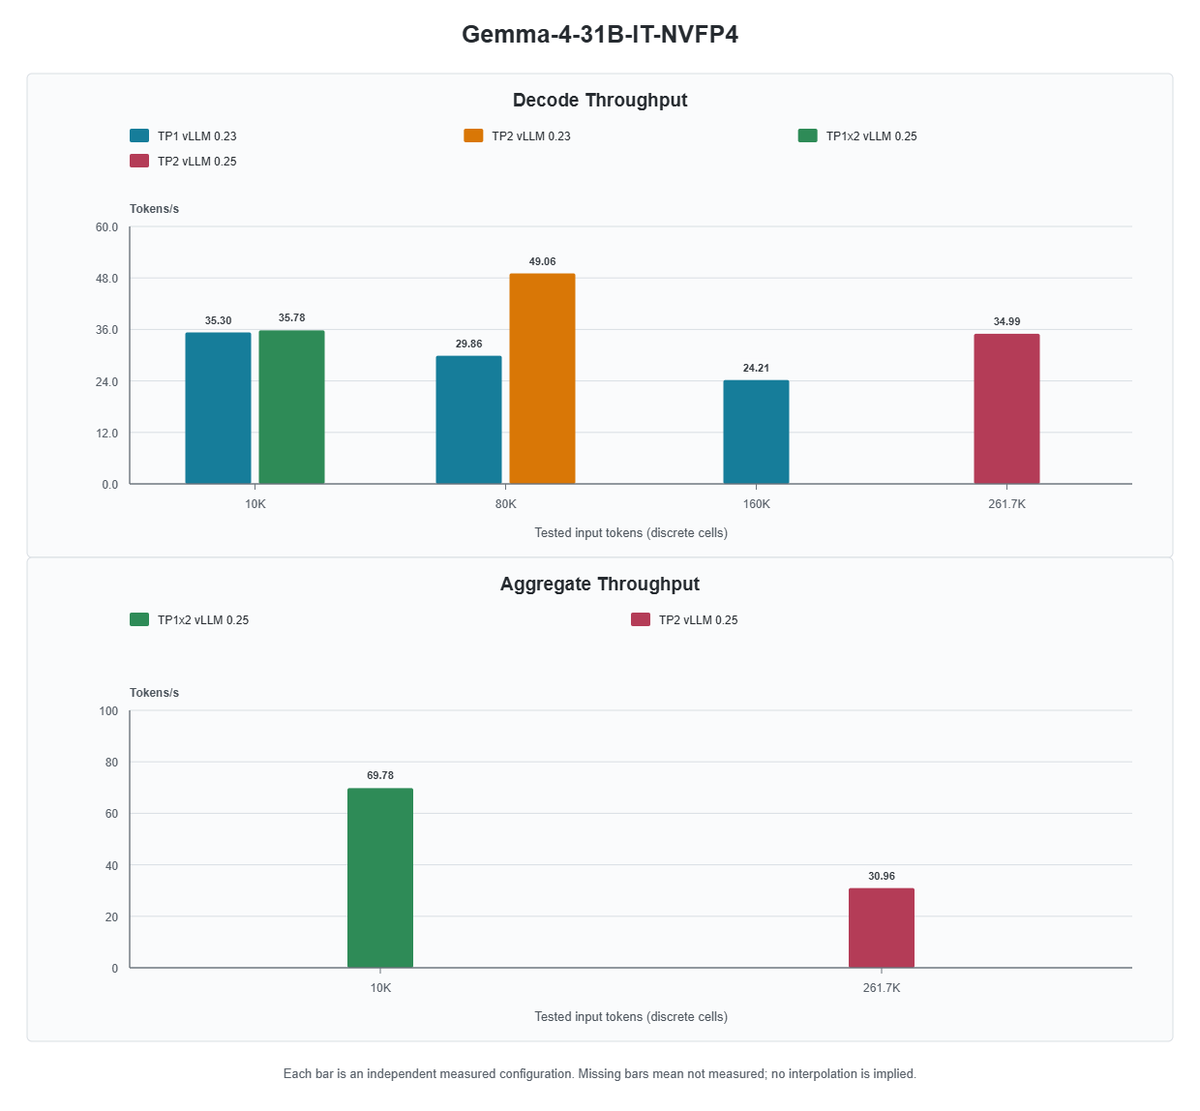
GemmaはvLLM 0.23系で10K、80K、160Kを測定し、vLLM 0.25で10Kとモデル上限付近を測定した。

gemma_context.svg

Runtime 入力 構成 出力 測定数 Decode Aggregate 統計
v0.23.1-dev 10,025 TP1、c1 256 5 35.300 35.300 平均
v0.25.0 10,025 TP1を2プロセス、合計c2、prefix cache有効 256 5 35.784 69.781 平均
v0.23.1-dev 80,025 TP1、c1 256 3 29.862 29.862 平均
v0.23.1-dev 80,025 TP2、c1 256 3 49.056 49.056 平均
v0.23.1-dev 160,015 TP1、c1 30、256、256 3 24.207 24.207 平均
v0.25.0 261,657 TP2、c1 256 1 34.987 30.956 単発

10KのvLLM 0.25構成は各GPUで88,600 MiB、約262Kの構成は各GPUで88,814 MiBを使用した。

vLLM 0.25の40Kと80Kは未測定である。

Gemmaの起動パラメーター

用途 TPとプロセス max_model_len max_num_batched_tokens max_num_seqs KV Cache Backend
10K TP1を2プロセス 11,000 4,096 1 FP8 prefix有効 vLLM auto
80K TP1またはTP2 81,000 4,096 1 FP8 prefix無効 vLLM auto
約262K TP2 262,144 4,096 1 FP8 prefix有効 CUTLASS

共通引数は--quantization modelopt --enable-chunked-prefill --trust-remote-code --gpu-memory-utilization 0.9である。

10K構成は同じコマンドをCUDA_VISIBLE_DEVICES=0と1で1プロセスずつ起動する。

Qwen3.6-35B-A3B-NVFP4

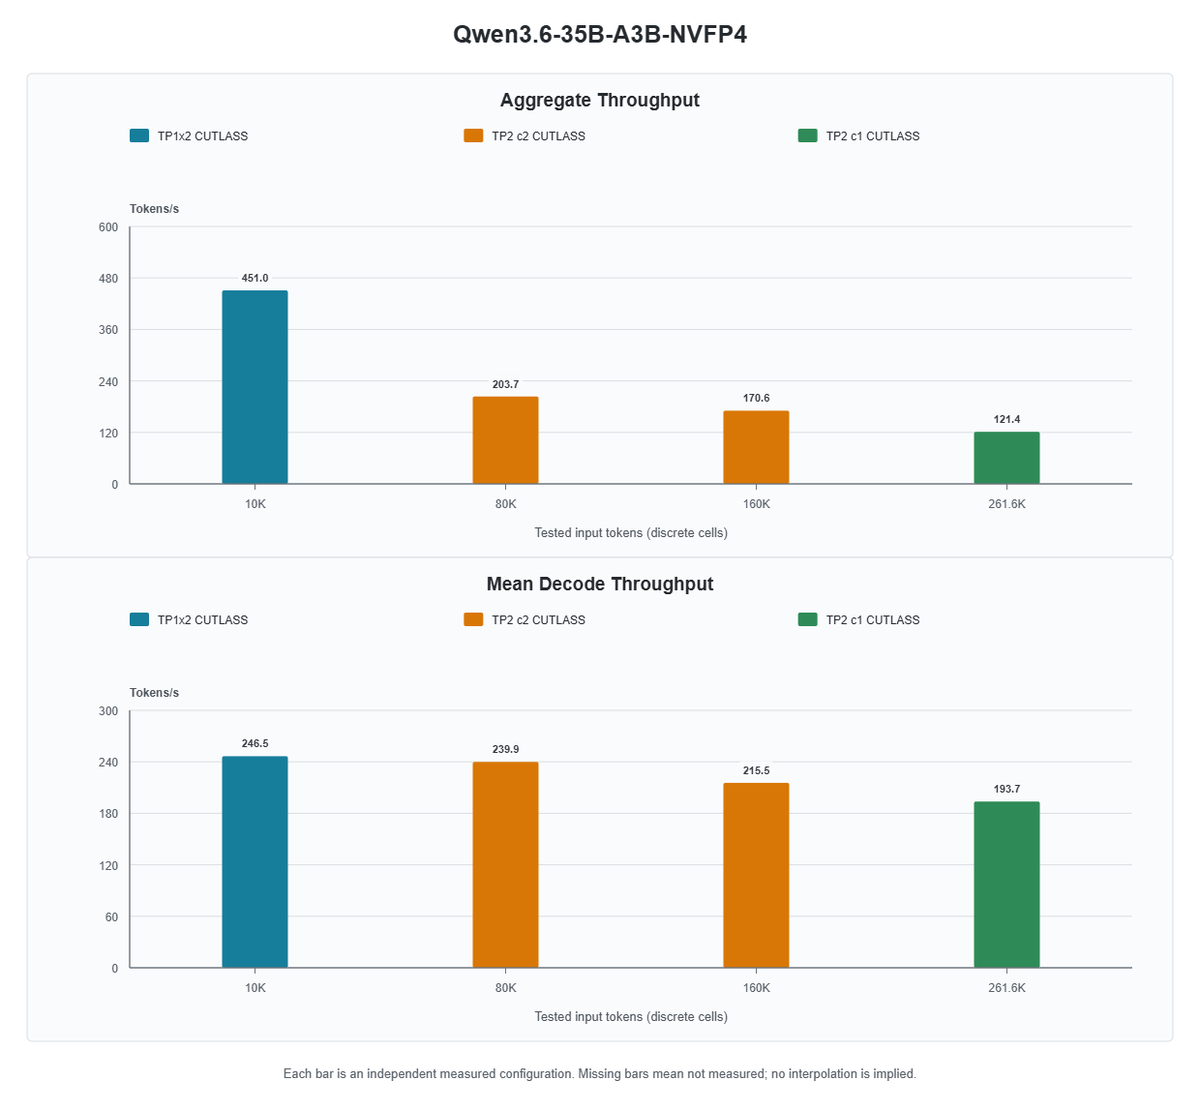
QwenはvLLM 0.25で10Kを5回測定し、80K、160K、モデル上限付近では4種類のlinear backend設定を比較した。

入力 構成 CUTLASS Aggregate CUTLASS Decode 4構成の範囲 測定数
10,005 TP1を2プロセス、各c2 451.027 246.534 CUTLASSのみ反復 5
80,005 TP2、c2 203.698 239.904 Aggregate 198.596から203.698、Decode 236.843から239.904 1/構成
160,005 TP2、c2 170.592 215.495 Aggregate 168.525から170.592、Decode 215.172から215.871 1/構成
261,637 TP2、c1 121.360 193.720 Aggregate 120.535から121.360、Decode 192.553から194.428 1/構成

比較した設定はCUTLASS、batch 4096、scoped FlashInfer B12x、scoped FlashInfer cuDNNである。

10Kの最高値との差が10%以内だった4構成は、すべて80K、160K、約262Kまで動作した。

Qwenの起動パラメーター

用途 TPとプロセス Concurrency max_model_len Batch Seqs Cache Linear backend
10K TP1を2プロセス 2/endpoint 11,000 8,192 1 prefix有効 CUTLASS
80K TP2 2 86,016 8,192 1 prefix有効 CUTLASS
160K TP2 2 166,400 8,192 1 prefix有効 CUTLASS
約262K TP2 1 262,144 8,192 1 prefix有効 CUTLASS

共通引数は--quantization modelopt --reasoning-parser qwen3 --enable-chunked-prefill --trust-remote-code --gpu-memory-utilization 0.9である。

MiMo-V2.5-NVFP4

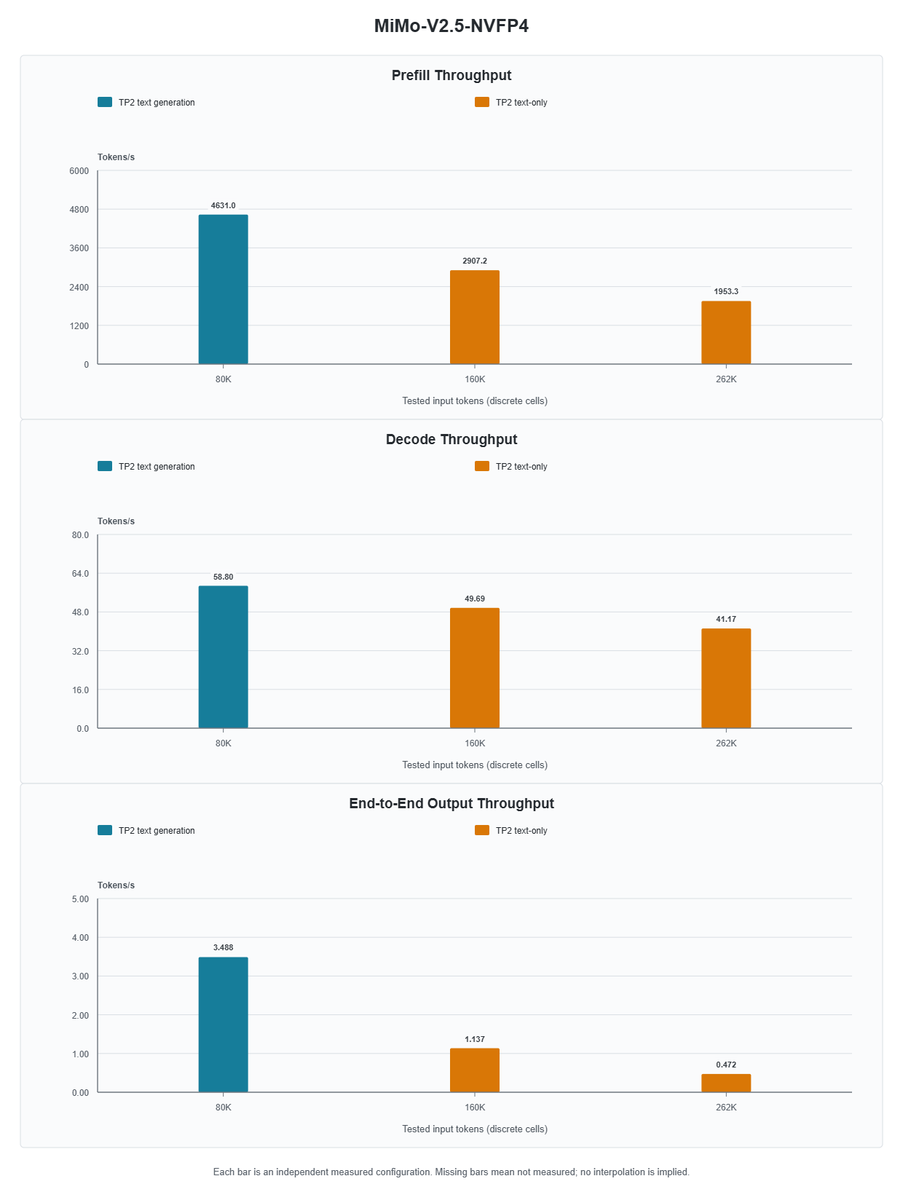
MiMoはModelOpt scaleとfused-QKVの処理を修正したvLLM 0.26で80Kを5回、160Kを3回、262Kを1回測定した。

Target入力 構成 出力 測定数 PF Decode E2E Peak VRAM
80K text generation 64固定 5 4,631.010 58.803 3.488 94,394 / 94,394 MiB
160K text-only 64固定 3 2,907.210 49.687 1.137 93,726 / 93,726 MiB
262K text-only 64固定 1 1,953.288 41.169 0.472 96,808 / 96,808 MiB

160Kと262Kでは--language-model-onlyを指定し、画像入力と動画入力を無効化した。この2条件はmultimodal servingの結果ではない。

80Kでは5 GiB/GPUのCPU offloadを外し、KV cacheを3 GiB/GPUへ固定した構成が、同一プロジェクトのSGLang測定よりE2Eを14.47%改善した。

MiMoの起動パラメーター

用途 max_model_len Batch KV bytes/GPU Offload language-model-only 測定数
80K 81,920 8,192 3,221,225,472 0 無効 5
160K 163,840 4,096 5,905,580,032 0 有効 3
262K 262,144 2,048 9,663,676,416 0 有効 1

全構成はTP2、FP8 KV、max_num_seqs=1、prefix cache無効、chunked prefill有効、FlashInfer autotune無効である。

使用したコンテナにはfused-QKVの並べ替えとModelOpt scale読込の修正を含む。

GPT-OSS-120B

GPT-OSSは80Kでcold prefixとhot prefixを分け、131,072-token上限の直前まで確認した。

条件 入力 出力 測定数 PF Decode E2E 統計
Cold、batch 4096 80K target 自然EOS、上限256 1 6,704.818 112.172 18.001 単発
Cold、batch 8192 80K target 自然EOS、上限256 1 6,729.192 112.936 18.068 単発
Cold、batch 16384 80K target 自然EOS、上限256 1 6,723.027 113.190 18.069 単発
Hot、batch 4096 80K target 自然EOS、上限256 5 cache hit 112.370 101.447 平均
上限確認、batch 4096 131,030 16 1 4,670.574 比較外 比較外 単発

Coldはprefix cache無効かつ同長warmupなし、Hotはprefix cache有効かつ同長warmupありである。

Hotの高いE2Eは80K prefixのcache hitを含むため、ColdのPF性能とは別に扱う。

131,030入力と16出力の合計は131,046 tokensであり、モデル上限まで26 tokensを残した。

GPT-OSSの起動パラメーター

用途 TP max_model_len Batch Seqs KV Cache Warmup
80K Hot 2 81,000 4,096 1 auto prefix有効 同長1回
80K Cold 2 81,000 4,096から16,384 1 auto prefix無効 なし
約131K 2 131,072 4,096から16,384 1 auto prefix無効 なし

共通引数は--enable-chunked-prefill --cpu-offload-gb 0 --trust-remote-code --gpu-memory-utilization 0.92である。

自動kernel選択はMarlinを使用し、明示的なMXFP4 Triton MoEはSM120で非対応だった。

DeepSeek-V4-Flash

DeepSeekはGGUF系のDS4SparkとNVIDIA NVFP4を別variantとして評価した。

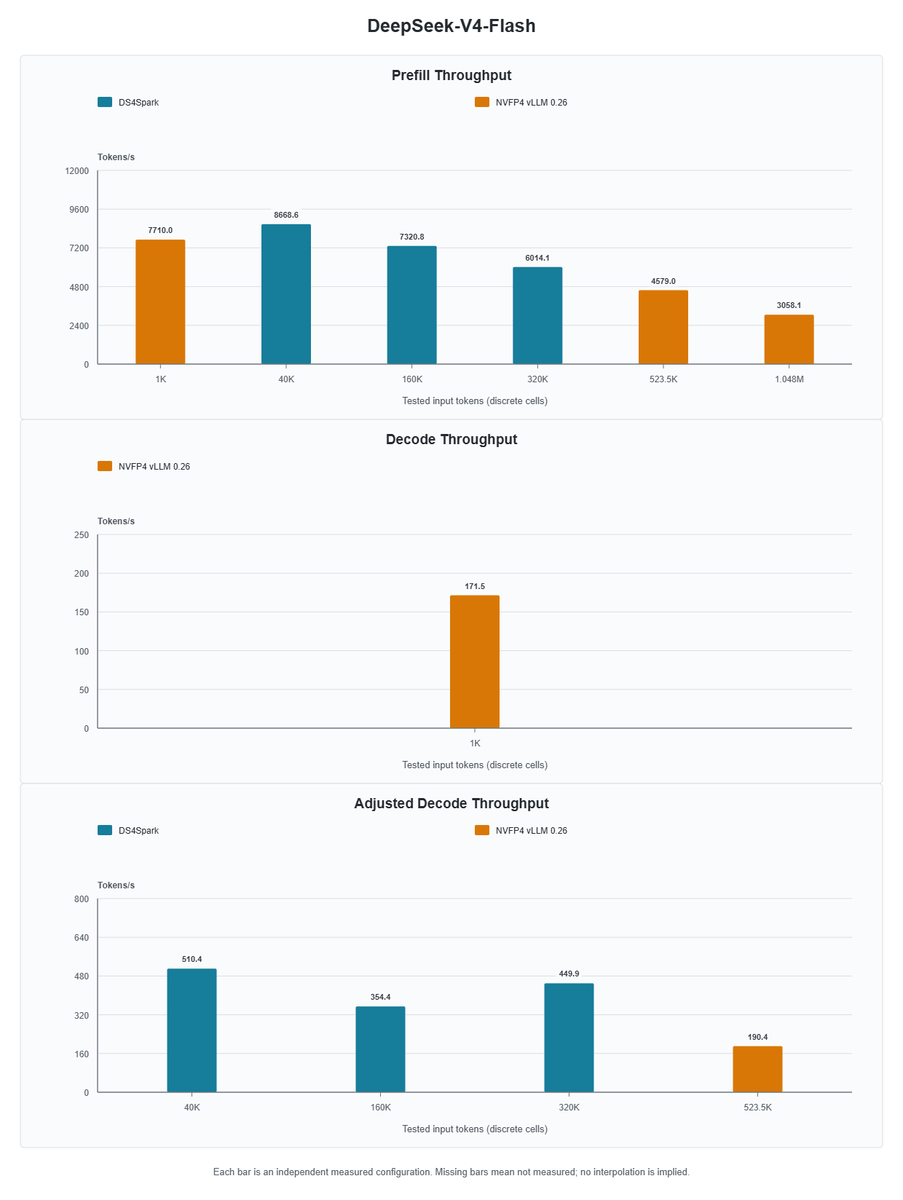
通常のDecodeとAdjusted Decodeは定義が異なるため、グラフでも別パネルに分けた。

DS4Spark

Target入力 PF Adjusted Decode 測定数 統計
40K 8,668.57 510.45 1 既存記録値
160K 7,320.75 354.37 1 既存記録値
320K 6,014.15 449.91 3 中央値

320KではMODE=dspark BACKEND=lucifer-cutlass TP_SIZE=2 MAX_MODEL_LEN=327680 MAX_BATCHED=4096 MAX_NUM_SEQS=1 GPU_MEMORY_UTILIZATION=0.96 PREFIX_CACHE=0 DSPARK_TOKENS=3を使用した。

DS4Sparkは40Kから320Kの測定範囲でPF 1,000 tok/sとAdjusted Decode 100 tok/sを上回った。

NVIDIA NVFP4

入力 構成 測定数 PF Decode Adjusted Decode E2E Peak VRAM
1,000 MTP=1、短文構成 5 7,710.001 171.501 比較外 比較外 89,766 / 89,766 MiB
523,518 PCIe向けcollective設定 5 4,579.001 比較外 190.354 4.375 95,130 / 95,130 MiB
1,047,519 既定collective設定 1 3,058.125 比較外 207.140 1.484 96,256 / 95,676 MiB

524KのPCIe向け設定は、同じ入力長の既定設定による単発値よりAdjusted Decodeを7.20%改善したが、PFは0.66%低下した。

約1Mでは既定collective設定がPCIe向け設定より速かった。

DeepSeek NVFP4の起動パラメーター

用途 TP max_model_len Batch Seqs GPU memory Cache MTP Collective
1K 2 4,096 8,192 16 既定値 prefix無効 1 default
524K 2 524,288 1,024 1 0.96 prefix無効 1 NCCL_P2P_LEVEL=4、NCCL_IB_DISABLE=1
約1M 2 1,048,576 1,024 1 0.96 prefix無効 1 default

共通引数はFP8 KV、chunked prefill有効、CPU offload 0、--quantization modelopt --trust-remote-codeである。

Hy3-NVFP4-W4A16

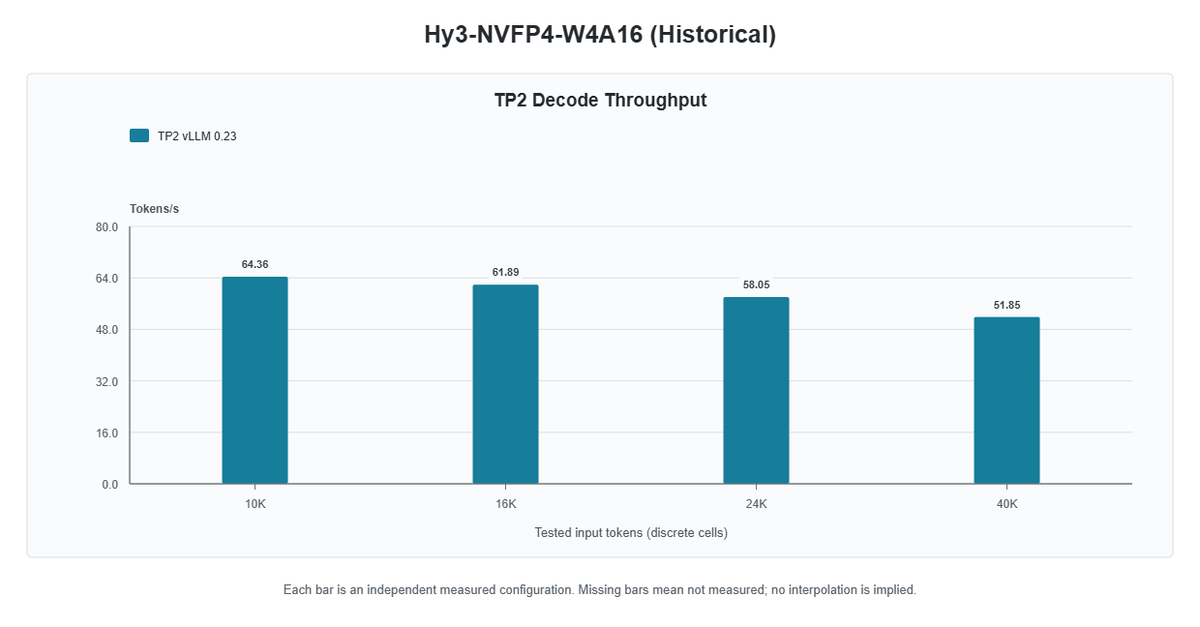
Hy3 W4A16はvLLM 0.23.1-devとTP2で40Kまで動作した。

入力 Decode 測定数 統計
10,005 64.363 5 平均
16,005 61.893 1 既存記録値
24,005 58.055 1 既存記録値
40,005 51.849 1 単発

起動引数はTP2、max_model_len=11000または41000、gpu_memory_utilization=0.97、max_num_batched_tokens=2048、max_num_seqs=1、fastsafetensors、KV auto、async scheduling、chunked prefill有効だった。

Hy3 IQ1_M 1Bit

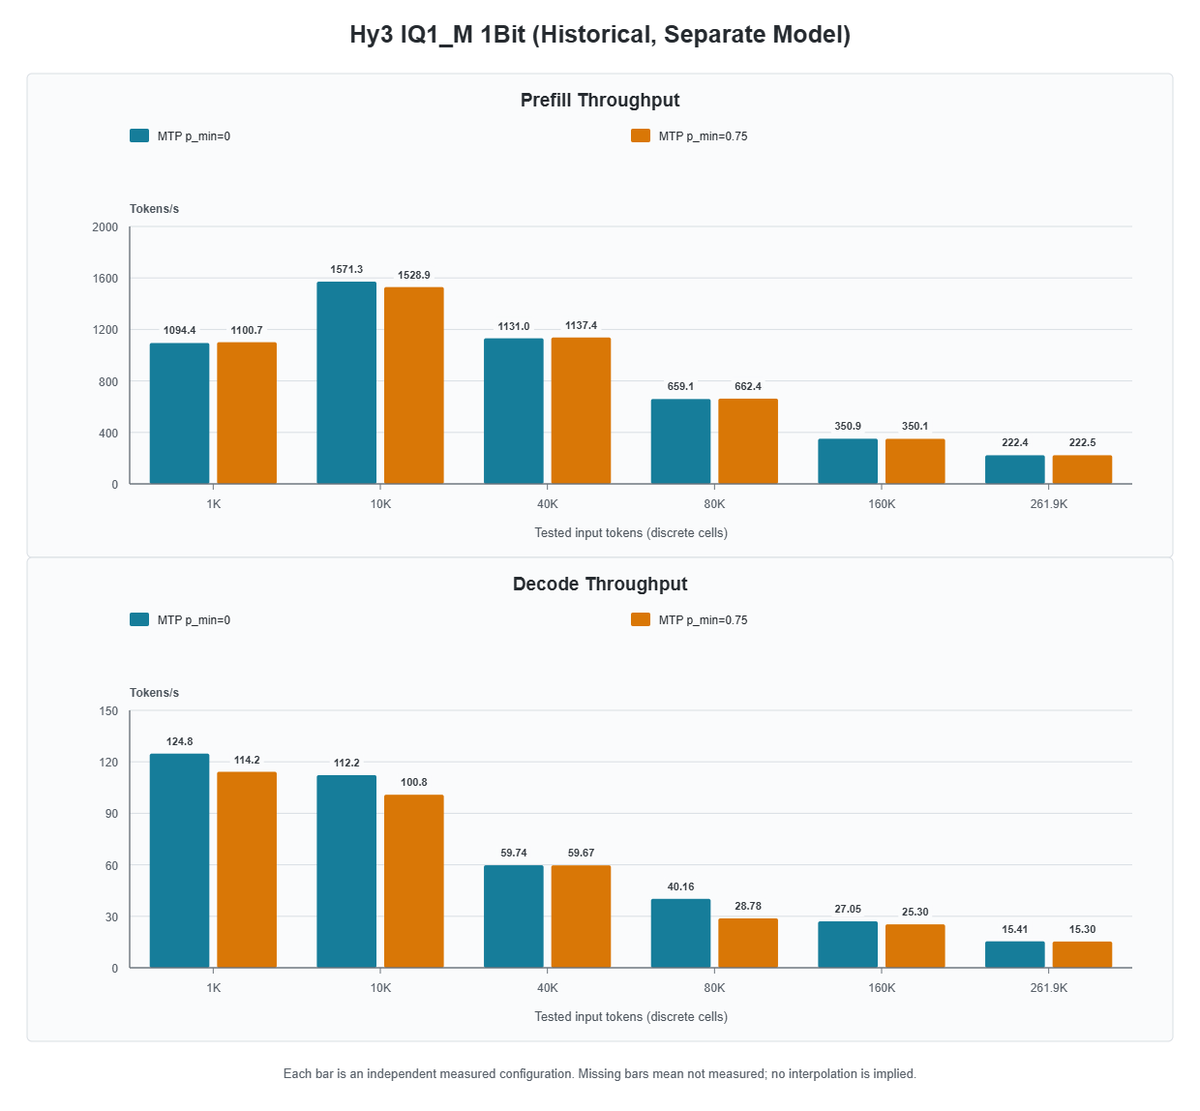
IQ1_MはW4A16とは別モデルであり、公式patchを適用したllama.cppでモデル上限まで動作した。

Prompt / total KV p_min=0 PF / Decode p_min=0.75 PF / Decode 測定数
1K / 1,256 Q8 1,094.38 / 124.79 1,100.72 / 114.19 1/構成
10K / 10,256 Q8 1,521.68 / 111.78 1,528.92 / 100.83 1/構成
40K / 40,256 Q8 1,130.95 / 59.74 1,137.37 / 59.67 1/構成
80K / 80,256 Q8 659.14 / 40.16 662.35 / 28.78 1/構成
160K / 160,256以上 Q8 350.87 / 27.05 350.07 / 25.30 1/構成
261,887 / 262,144 Q4 222.40 / 15.41 222.53 / 15.30 1/構成

別に取得したp_min=0の10K測定は、5回平均でPF 1,571.283、Decode 112.250、変動係数0.62%だった。

グラフではこの5回平均をp_min=0の10K値として使用した。

短文構成はQ8 KV、-c 10256 -n 256 -ngl 999 --split-mode layer --tensor-split 1,1 -b 2048 -ub 512 -fa on --spec-type draft-mtp --spec-draft-n-max 3 --spec-draft-p-min 0を使用した。

モデル上限の測定ではQ4 KVとtotal context 262,144を使用した。

Hy3実行中のホスト再起動

Hy3 W4A16のTP2 checkpoint load中に、2026年7月15日に2回、7月27日に1回、OSのshutdown記録を伴わないホスト再起動が発生した。

7月27日のログは50 shard中44 shardを読み込んだ位置で途切れ、コンテナはexit code 255、OOMKilled=falseだった。

直前のbootにはNVIDIA Xid、OOM Killer、kernel panic、MCE、fatal AER、thermal fault、watchdog expirationがなかった。

BMCはchassis power control commandとして分類したが、発行元と根本原因は特定できていない。

Redditにディスカッションがあった4番スロット近辺の4ピンヘッダーの絶縁、電源増設、BIOS更新を実施した。

電源増設後も事象が発生したので電源のスペック不足の線の可能性は低くなった。

GPUアクセスを分けた限定試験では再現しなかったが、高負荷試験と長時間試験を完了していない。

再起動とHy3の因果関係は確定していない。

参考資料

Threadripper PRO構成でファイルサーバーを新調した

これは自宅のファイルサーバーを新調したときのハードウェア選定と検証内容のメモです。 Threadripper PRO ベースで構成しました。

購入品と価格

購入時点の単価は以下の通り。

パーツ 購入時価格 メモ
(ebayで購入、新品)Gigabyte MC62-G40 Rev 1.0 $489.27 WRX80マザーボード
(ebayで購入、新品)AMD Ryzen Threadripper Pro 3975WX $730.50 32C/64T CPU
(aliで購入、新品)SlimSAS SFF-8654 4i → SATA x4 ケーブル 1m $7.08 SFF-8654 4i から SATA x4 への分岐ケーブル
(国内通販で購入、新品)東芝 MG11ACA24TE 24TB 84,980円 HDD
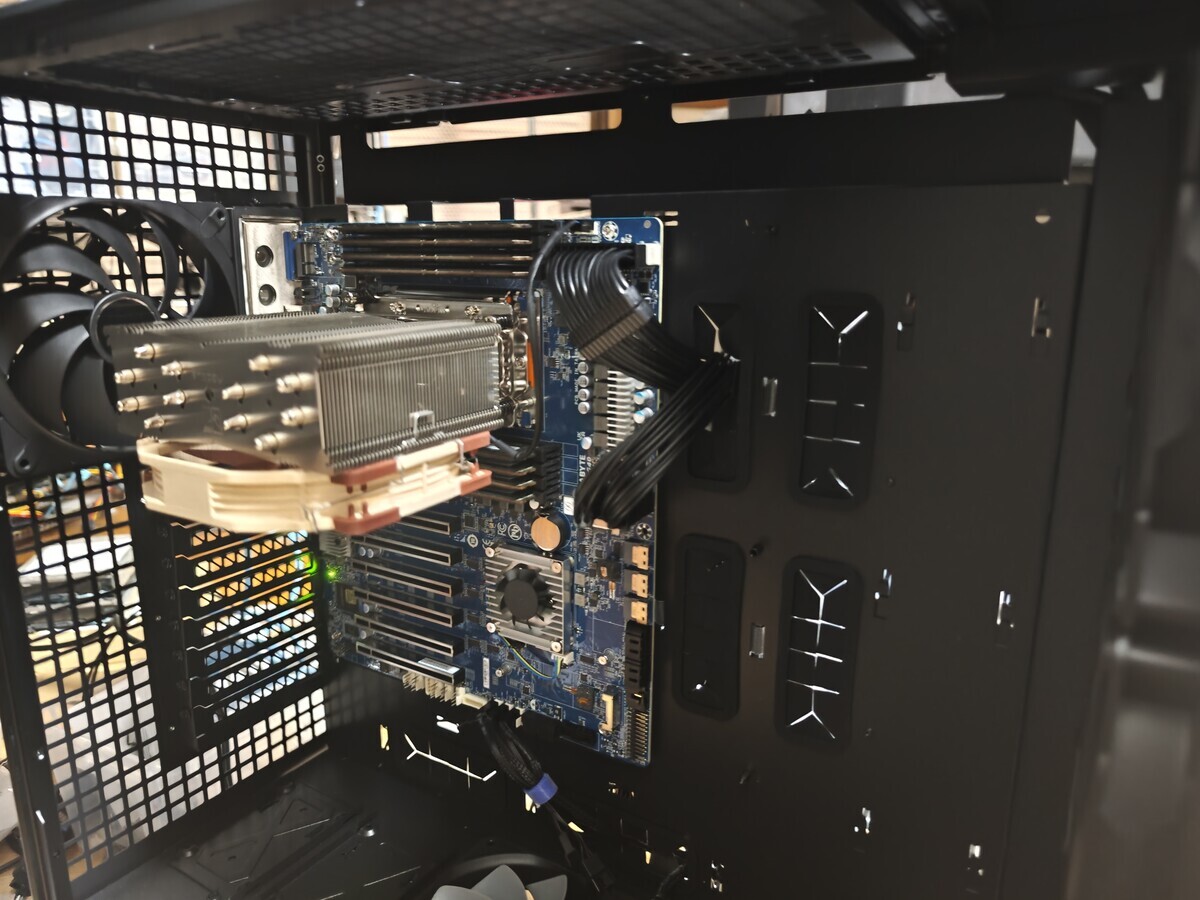
(国内通販で購入、新品)Antec 900 34,320円 ケース
(国内通販で購入、新品)Noctua NH-U14S TR4-SP3 13,625円 CPUクーラー
(中古)DDR4 ECC UDIMM 32GB N/A 既存パーツを流用

ハードウェア選定

AMD Ryzen Threadripper Pro 3975WX

項目 内容
製品 AMD Ryzen Threadripper Pro 3975WX
世代 / アーキテクチャ Zen 2 世代 Threadripper PRO
コア / スレッド 32コア / 64スレッド
ベースクロック 3.5GHz
最大ブーストクロック 4.2GHz
L2キャッシュ 16MB
L3キャッシュ 128MB
TDP 280W
メモリ DDR4-3200、8チャネル
PCIe PCIe 4.0、128レーン

PCIeレーン数の多さが魅力です。新品で$489.27は破格でした。 なお、中古のものはベンダーロック(例えばLenovo機器からの取り外し品なら同じLenovoのマザーボードとの組み合わせでしか動作しない)がかかってるものが多く、選定の対象外としたほうが無難です。

server_manual__MC62-G40_e_1001.pdf p.8

Gigabyte MC62-G40

項目 内容
製品 Gigabyte MC62-G40
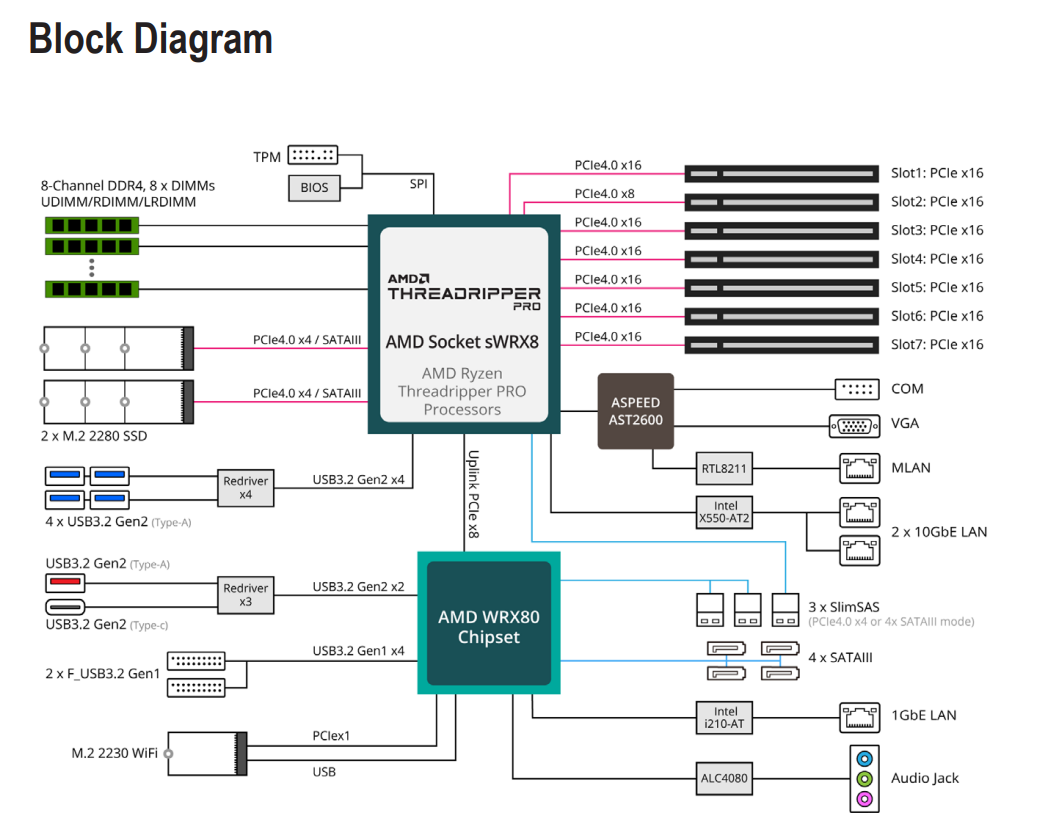
チップセット AMD WRX80
CPUソケット sWRX8
対応CPU AMD Ryzen Threadripper PRO 3000 / 5000 WX-Series
メモリ 8-channel, 8 x DDR4 ECC/Non-ECC DIMM slots, Up to 3200 MT/s
SATA オンボード SATA 6Gb/s x4
SlimSAS SlimSAS SFF-8654 4i x3
PCIe PCIe x16 (Gen4 x16) x 6, PCIe x16 (Gen4 x8) x1
管理機能 BMC / IPMI

SlimSAS x3 を SATA x4 に分岐して 12ポート、オンボード SATA x4 と合わせて最大16ポートのSATAが使用できます。 PCIe拡張スロット数も十分です。

後述しますが、実際に検証するまで分からなかったよい点として、HDDのスタッガードスピンアップに対応していました。 PUISに対応したHDDで機能を有効にしておくと、通電のタイミングではなくBIOS起動後の処理でHDDを順番にスピンアップしてくれます。 これによってスピンアップ時の電源負荷を散らしてくれるので、小さな電源でHDD群を運用できます。電源にも優しい機能です。

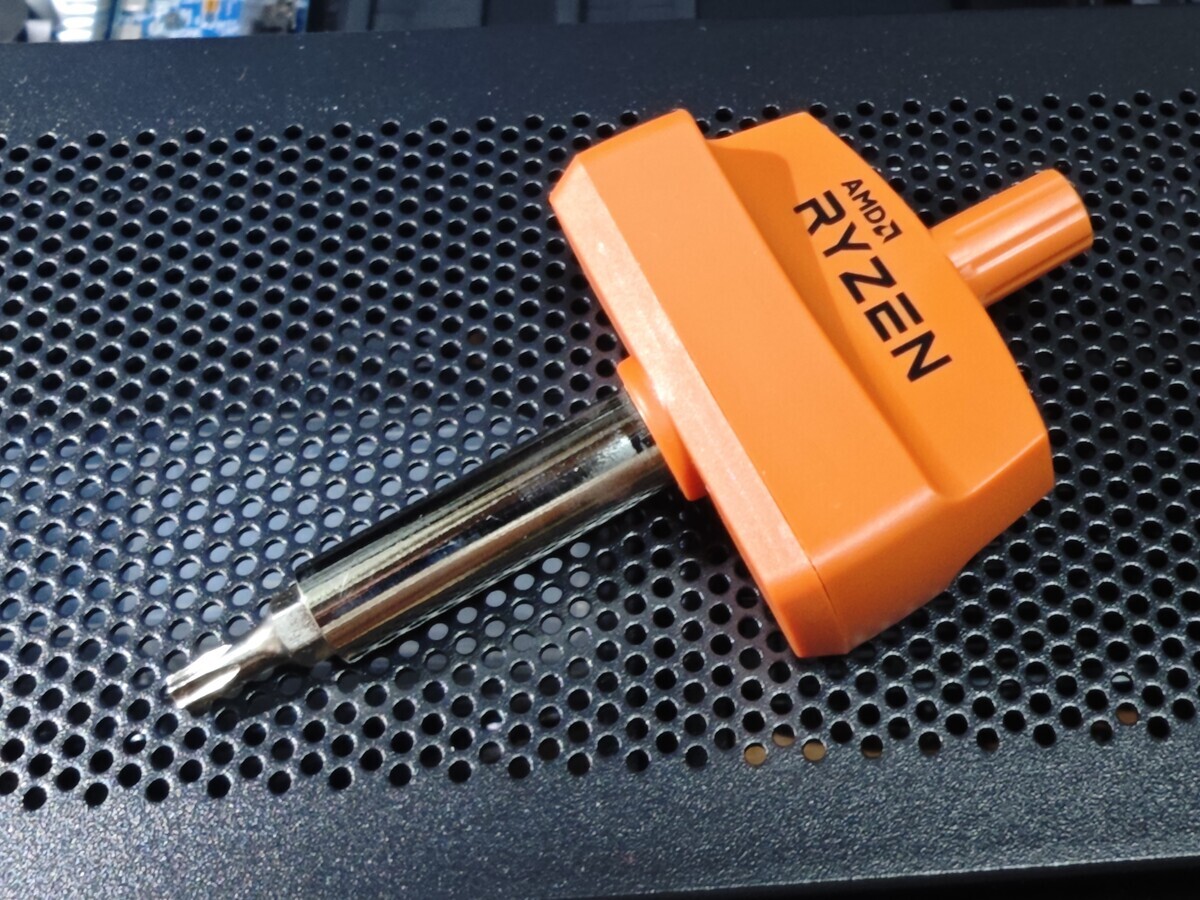
課題: CPUの固定にトルクレンチが必要

Threadripper用のもの(あるいは同等品)が手持ちになければ購入する必要があります。

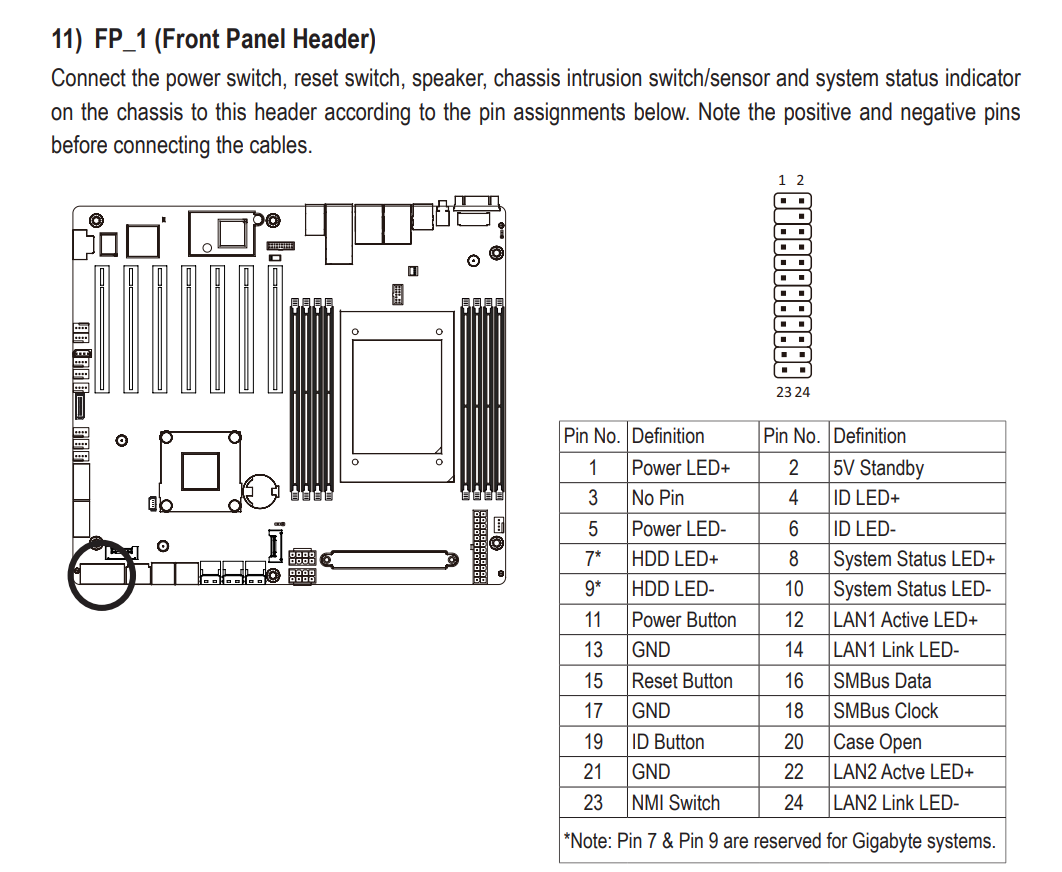
課題: 独自仕様のフロントパネルヘッダー

フロントパネルヘッダーが独自仕様で、使用する場合は注意が必要。マザーボードによっては別途変換用のケーブルが必要です。 BMCで管理を行えればよいため、私はこの端子を使っていません。 その後、電源オン用途だけ使用するようになりました。ピンヘッダーのサイズは通常の2.54mmなので特に使用は難しくはありません。

server_manual__MC62-G40_e_1001.pdf p.22

メモリ

メモリは家にあった DDR4 ECC UDIMM 32GB (M391A4G43MB1-CTD) を使うことにしました。QVLに未記載ですが安定しています。

課題: LRDIMMの互換性

同じくQVLに未記載のLRDIMMも試しましたが、こちらは安定しませんでした。

課題: LRDIMMの発熱

LRDIMMは温度も高くなりやすく、運用時はメモリ周辺に風を当てるファンが必須になりそうでした。

BMC/IPMIまわり

2026年6月15日 追記: BMCのファームウェアアップデート (13.06.25)を実施して評価中です。以下の課題は解消する可能性があります。

課題: DIMM温度センサーの不安定さ

BMCまわりでは、DIMMの温度センサーを見失うことがありました。タイミングの問題なのか、センサーがずっと無効扱いになることがあります。BMCを含めて再起動すると、うまく拾えることもありました。

課題: アラーム閾値を保存できない謎仕様

ファンの速度がデフォルトのアラーム閾値に引っかかりました。閾値を変更しても保存できず、電源オフで初期値に戻ってしまうため、BMC側で対処するのは諦めました。最終的にはPrometheus側の監視ロジックを調整して対応しています。

課題: 謎のライセンス切れ

License is not available for the requested URL. [code:15003] というエラーが発生し、リモートコントロールなどの機能が使えなくなる。これはファームウェアアップデートで解消した。

PrometheusでBMC/IPMIを監視する

BMC/IPMIの監視は ipmi_exporter を使い、Prometheus Operator の ServiceMonitor と PrometheusRule で実装しました。

ここではサーバー1台を監視する前提で書きます。BMCのIPアドレスはここでは 192.0.2.10 とします。

ファイル構成

server-metrics/
├── kustomization.yaml
├── ipmi-exporter-deployment.yaml
├── ipmi-exporter-service.yaml
├── ipmi-exporter-servicemonitor.yaml
├── ipmi-exporter-networkpolicy.yaml
└── server-ipmi-rules.yaml

ServiceMonitor では /ipmi を scrape し、__param_target にBMCのIPアドレスを渡します。bmc と server ラベルも付けておくと、PromQLやAlertmanager側で扱いやすくなります。

endpoints:
  - port: http
    path: /ipmi
    interval: 1m
    scrapeTimeout: 30s
    params:
      module:
        - mc62-g40
    relabelings:
      - targetLabel: __param_target
        replacement: 192.0.2.10
      - targetLabel: instance
        replacement: 192.0.2.10
      - targetLabel: bmc
        replacement: 192.0.2.10
      - targetLabel: server
        replacement: MC62-G40

BMC監視は管理系ネットワークへの通信になるため、NetworkPolicyで通信先を絞り、Prometheusから exporter への TCP/9290 と、exporter からBMCへの UDP/623 だけを許可します。

ingress:
  - from:
      - podSelector:
          matchLabels:
            app.kubernetes.io/name: prometheus
    ports:
      - protocol: TCP
        port: 9290

egress:
  - to:
      - ipBlock:
          cidr: 192.0.2.10/32
    ports:
      - protocol: UDP
        port: 623

アラートは、exporterのscrape失敗、IPMIセンサー取得失敗、シャーシ電源OFF、センサー状態、ファン回転数などを見るようにしました。

ファン速度については、BMC側の閾値が運用に合わなかったため、Prometheus側で実運用に合わせて調整しました。 次のように、BMCのstate系メトリクスでは一部のファンを除外し、必要な回転数は別ルールで見る形にしています。

- alert: ServerIPMISensorCriticalState
  expr: |
    ipmi_temperature_state{bmc="192.0.2.10"} >= 2
    or ipmi_fan_speed_state{bmc="192.0.2.10", name!~"SYS_FAN[678]"} >= 2
    or ipmi_voltage_state{bmc="192.0.2.10"} >= 2
    or ipmi_current_state{bmc="192.0.2.10"} >= 2
    or ipmi_power_state{bmc="192.0.2.10"} >= 2
    or ipmi_sensor_state{bmc="192.0.2.10"} >= 2
  for: 5m
  labels:
    severity: critical

- alert: ServerIPMISensorWarningState
  expr: |
    ipmi_temperature_state{bmc="192.0.2.10"} == 1
    or ipmi_fan_speed_state{bmc="192.0.2.10", name!~"SYS_FAN[678]"} == 1
    or ipmi_voltage_state{bmc="192.0.2.10"} == 1
    or ipmi_current_state{bmc="192.0.2.10"} == 1
    or ipmi_power_state{bmc="192.0.2.10"} == 1
    or ipmi_sensor_state{bmc="192.0.2.10"} == 1
  for: 5m
  labels:
    severity: warning
- alert: ServerFanSpeedCritical
  expr: |
    ipmi_fan_speed_rpm{bmc="192.0.2.10", name=~"SYS_FAN[678]"} < 300
  for: 5m
  labels:
    severity: critical

- alert: ServerFanSpeedWarning
  expr: |
    (
      ipmi_fan_speed_rpm{bmc="192.0.2.10", name=~"SYS_FAN[678]"} < 500
      and on(instance, id, name)
      ipmi_fan_speed_rpm{bmc="192.0.2.10", name=~"SYS_FAN[678]"} >= 300
    )
  for: 5m
  labels:
    severity: warning

SlimSASとSATA

課題: SlimSASの Auto でSATAデバイスを認識しない

SlimSASの動作モードを Auto にしていると、SATAディスクが自動認識されませんでした。そのため、BIOS側でSlimSASの動作モードを明示的に設定する必要がありました。

よかった点: スタッガードスピンアップ対応

SlimSAS経由のSATAはスタッガードスピンアップに対応していました。HDD側で PUIS を有効にすると、電源投入直後ではなく、BIOS起動時にドライブが順次スピンアップします。

PUISを有効にする場合は、対象ディスクを確認してから hdparm を実行します。 以下は /dev/sda に対して有効化する例です。

/dev/sda は環境によって変わるため、実行前に lsblk や /dev/disk/by-id/ で対象ディスクを確認してください。

hdparm -s1 --yes-i-know-what-i-am-doing /dev/sda

ホットプラグに対応しているので、毎回再起動せずにディスクを取り外すこともできます。

echo 1 > /sys/block/sda/device/delete

ProxmoxでのPCI passthrough

端末にはProxmoxをインストールし、ゲストとしてTrueNASでファイルサーバーを立てています。 ストレージ関連のデバイスをパススルーしてゲストに割り当てて、ゲスト側からデバイスを直接使う構成がおすすめです。

qm set 120 -hostpci0 0000:45:00.0,pcie=1
qm set 120 -hostpci1 0000:67:00.0,pcie=1
qm set 120 -hostpci2 0000:68:00.0,pcie=1

対象デバイスは vfio-pci にバインドしておきます。

echo "options vfio-pci ids=1022:7901" > /etc/modprobe.d/vfio.conf
update-initramfs -u
reboot

まとめ

WRX80 + Threadripper PRO 構成はNASとしては過剰なスペックですが、多機能サーバーとして使用するならPCIeレーン数は多いほうが安心です。 もし同じような環境を構築される場合、注意点としては、少なくとも私のセットアップでは、BMCのセンサー取得が不安定になること、ファン閾値が保存されないこと、SlimSASのSATA認識には明示的な設定が必要だったことに注意してください。

Zstandard 共有辞書をクローラーの保存形式に組み込む

注意

この記事は実際の実験データを元にLLMが生成したものです。

文体にAI臭がありますが、データは実際のものに基づいています。

要旨

長期運用しているクローラーでは、保存データ量がそのままストレージ費用に反映されます。圧縮率の改善は、インフラ費用とアーカイブ運用の両方に効く、継続的に取り組む価値のあるテーマです。

今回の検証では、まず Zstandard(以下 zstd)を辞書なしで使う標準方式を参照値として測定しました。そのうえで、サイト単位で学習した辞書を各レコードに適用するサイト単位辞書方式を比較しました。

結果として、サイト単位辞書方式は標準方式と比べてアーカイブ本体サイズ比を 25.7〜66.1% 削減しました。さらに、共有辞書の学習サンプル、辞書サイズ、学習条件を調整すると、辞書込み実効サイズ比は元データの 7.689〜14.251% になりました。

zstd の共有辞書は、クローラーの蓄積データに対して保存効率を改善する有力な選択肢だと考えられます。一方で、辞書を使う方式では、書き込み、読み込み、再学習、互換性管理で考慮点が増えます。圧縮率だけで採用を決めず、保存形式全体の設計として評価するのが現実的です。

共有辞書の基本

zstd の辞書圧縮は、代表的なサンプルから辞書を学習し、その辞書を圧縮時と展開時の両方で参照する方式です。辞書には、対象データに繰り返し現れるバイト列や構造が入ります。圧縮対象のレコードが短い場合でも、辞書側に共通パターンがあれば、個々のレコードをより短く表現できます。

クローラーが保存するページには、HTML テンプレート、メタデータ、定型的な属性値、本文の書式、サイト固有のマークアップなどが繰り返し含まれます。共有辞書方式の狙いは、こうした共通部分を各ページの圧縮データに繰り返し持たせるのではなく、辞書側に寄せることです。

ここでいう共有辞書とは、1 つのページ専用の辞書ではなく、複数のページで共有する辞書です。たとえば、あるサイトの一定期間のページ群から辞書を学習し、そのサイトの保存レコードに同じ辞書を使います。圧縮データには、復元に必要な辞書 ID や辞書世代を記録します。

この方式では、圧縮データだけでは展開できません。読み込み時には、圧縮時に使った辞書を解決し、展開処理に渡す必要があります。したがって、共有辞書は圧縮率の改善手段であると同時に、保存形式に新しい管理対象を追加する設計です。

クローラー保存データでの償却

共有辞書を使う場合、辞書ファイルそのものも保存対象になります。したがって、評価では「各レコードの圧縮後サイズ」だけでなく、「共有辞書のサイズをどの保存量に負担させるか」も見る必要があります。

たとえば 20MiB の辞書を 1GiB の保存データだけで使う場合、辞書の負担は相対的に大きくなります。同じ 20MiB の辞書を 16GiB の保存データで共有できる場合、1 レコードあたり、または 1GiB あたりの辞書負担は小さくなります。この考え方を、本稿では辞書サイズの償却と呼びます。

今回の比較では、まずアーカイブ本体サイズ比を見ます。これは、評価対象レコードを圧縮した後のアーカイブ本体サイズを、圧縮前の本文サイズで割って求めます。

アーカイブ本体サイズ比 = 圧縮後のアーカイブ本体サイズ / 圧縮前の本文サイズ

共有辞書を使う方式では、別に辞書込み実効サイズ比も見ます。これは、アーカイブ本体に共有辞書の償却分を加えた実効保存量を、圧縮前の本文サイズで割った比率です。

辞書込み実効サイズ比 = (圧縮後のアーカイブ本体サイズ + 共有辞書の償却分) / 圧縮前の本文サイズ

この指標を見ることで、アーカイブ本体だけでは有利に見える大きな辞書が、辞書サイズ込みでも採用できるかを確認できます。

検証方法

対象は 3 種類のサイトデータです。本文ではサイト名を匿名化し、Site A、Site B、Site C と表記します。

ケース 主な言語 サイト種別
Site A 日本語 小説投稿サイト
Site B 日本語 小説投稿サイト
Site C 英語 百科事典型サイト

検証では、データを 3 つの役割に分けます。辞書を作るための学習データ、候補辞書を比べるための選定用サンプル、最後に結果を確認するための評価データです。評価データは辞書学習や候補選定には使わず、選んだ候補を全件に適用してアーカイブ本体サイズ比を測るために使います。

まず、標準方式とサイト単位辞書方式を比較します。標準方式は、辞書管理を持たない通常の zstd 圧縮です。辞書方式との比較条件をそろえるため、圧縮レベルは level 22 にしています。

サイト単位辞書方式は、サイト単位で学習した辞書を各レコードの zstd 圧縮に適用する構成です。以下では短く、サイト辞書とも呼びます。辞書方式を導入したときに、まず到達しやすい基準と考えられます。

標準方式とサイト辞書の比較

辞書を使わない標準方式を参照値として置きます。標準方式には共有辞書がないため、ここではアーカイブ本体サイズ比だけを示します。

ケース アーカイブ本体サイズ比
Site A 26.604%
Site B 32.554%
Site C 14.011%

次に、サイト辞書を同じ償却対象データ量で見ます。サイト辞書でも共有辞書を保存するため、辞書込み実効サイズ比は償却対象データ量によって変わります。

ケース 償却対象データ量 アーカイブ本体サイズ比 辞書込み実効サイズ比 共有辞書サイズ
Site A 1GiB 9.014% 9.112% 1.00 MiB
Site A 8GiB 9.014% 9.026% 1.00 MiB
Site A 16GiB 9.014% 9.020% 1.00 MiB
Site B 1GiB 15.083% 15.181% 1.00 MiB
Site B 8GiB 15.083% 15.095% 1.00 MiB
Site B 16GiB 15.083% 15.089% 1.00 MiB
Site C 1GiB 10.415% 10.659% 2.50 MiB
Site C 8GiB 10.415% 10.446% 2.50 MiB
Site C 16GiB 10.415% 10.430% 2.50 MiB

この結果から、zstd 辞書方式では、まず辞書の有無が結果に影響していることが分かります。特に Site A と Site B では、単純なサイト辞書だけでアーカイブ本体サイズ比が半分以下になっています。

Site C は英語の定型的な HTML データで、標準方式の時点でも Site A、Site B より小さく圧縮されています。ただし、これは「英語のほうが常に縮みやすい」という単純な話ではありません。文字種の違いに加えて、HTML テンプレートの反復量、ページ長の分布、メタデータや属性値の比率が重なった結果として見るのが妥当です。

圧縮と展開のフロー

辞書なしの標準方式では、圧縮データだけで展開できます。保存形式としては単純で、データの寿命が長いアーカイブでも扱いやすい構成です。

書き込み:
  HTTP レスポンス本文
    -> zstd 圧縮
    -> 圧縮データを保存

読み込み:
  圧縮データを取得
    -> zstd 展開
    -> HTTP レスポンス本文

共有辞書方式では、圧縮時と展開時の両方で同じ辞書が必要になります。保存データには、圧縮データ本体に加えて、どの辞書で圧縮したかを示す辞書 ID を記録します。

書き込み:
  HTTP レスポンス本文
    -> 対象サイトまたは対象データ群の辞書 ID を決定
    -> 対応する共有辞書を使って zstd 圧縮
    -> 圧縮データと辞書 ID を保存

読み込み:
  圧縮データと辞書 ID を取得
    -> 辞書 ID から共有辞書を解決
    -> 共有辞書を使って zstd 展開
    -> HTTP レスポンス本文

方式ごとの違いを整理すると、次のようになります。

観点 標準方式 共有辞書方式
圧縮時 レコード単体で圧縮できる 辞書 ID の決定と辞書ロードが必要
展開時 圧縮データだけで復元できる 圧縮時と同じ辞書が必要
保存メタデータ 圧縮方式とレベルが中心 辞書 ID、辞書世代、互換性情報が必要
再学習 不要 新しい辞書を成果物として管理する
障害時 圧縮データがあれば復元可能 辞書欠損時のリカバリが必要

この違いは、圧縮率の改善と引き換えに発生するアーキテクチャ上のコストです。共有辞書方式を採用する場合は、圧縮後サイズだけでなく、辞書 ID の管理、辞書の配布、辞書キャッシュ、古い辞書の保持期間を合わせて設計します。

圧縮・展開ベンチマーク

共有辞書方式では、圧縮時と展開時の両方で、辞書がどこにあるかによって性能特性が変わります。特にランダムアクセスが多いワークロードでは、辞書キャッシュが効く場合と効かない場合の差が出ます。

参考値として、Site A の評価データから 200 件を取り出し、標準方式と共有辞書方式の圧縮・展開時間を測りました。圧縮レベルは level 22、共有辞書サイズは 2.00MiB、測定は 5 回実行し、中央値を示しています。測定対象の raw データは 10.61MiB、1 レコードあたり平均 53.1KiB です。

方式 辞書状態 圧縮中央値(200件) 展開中央値(200件) 圧縮後サイズ比
標準方式 辞書なし 2,155.9ms 5.5ms 26.36%
共有辞書方式 メモリ上に辞書あり 4,060.7ms 2.9ms 9.35%

この測定では、共有辞書方式の圧縮は標準方式より遅くなりました。一方で、展開は辞書がメモリ上にある場合、標準方式より短くなっています。これは、このサンプルでは辞書方式の圧縮後サイズが小さく、展開する入力バイト数が減っているためと考えられます。ただし、展開時間はCPU、データサイズ、辞書キャッシュの状態に影響されるため、この結果だけで一般化するのは避けます。

辞書ロードの影響を見るため、同じ圧縮データに対して展開時の辞書解決を変えた測定も行いました。

辞書の扱い 展開中央値(200件) 説明
メモリ上の辞書を再利用 2.9ms アプリケーション側で辞書キャッシュが効いている状態
ローカルファイルから1回ロード 5.9ms 200件の展開前に辞書を1回読み込む状態
レコードごとに辞書をロード 38.7ms キャッシュが効かず、各レコードで辞書解決が発生する状態

ローカルファイルからのロードは、OSのファイルキャッシュが効いた可能性があります。そのため、永続ストレージの物理I/Oを代表する値ではなく、同一環境での参考値として扱います。

ネットワークから辞書を取得するケースは、今回のローカル測定では実測していません。概算する場合は、次のように分解します。

ネットワーク辞書取得時の読み込み時間
  ~= 圧縮データ取得時間 + ネットワーク往復遅延 + 辞書転送時間 + 展開時間

辞書転送時間
  ~= 共有辞書サイズ / 実効スループット

大きな共有辞書を採用すると、アーカイブ本体サイズ比は改善しやすくなります。一方で、辞書キャッシュが効かない読み込みでは、辞書サイズがそのまま追加取得量になります。したがって、保存量の評価では辞書込み実効サイズ比を見ますが、性能評価ではキャッシュヒット率、辞書ロード時間、辞書切り替え頻度を別に測る必要があります。

共有辞書のチューニング

ここからは、標準的なサイト辞書からさらに保存効率を改善するために試したチューニング手法です。zstd の共有辞書そのものの一般論ではなく、クローラーの保存データに合わせて辞書を設計するための候補探索です。

今回のチューニングでは、辞書サイズ、学習サンプルの作り方、辞書学習パラメータ、候補選定の安定性を調整しました。各要素の役割は次のとおりです。

手法 変えるもの 期待する効果 増えるコスト
Large Dictionary 共有辞書サイズ 長い定型構造やページ種別ごとの差分を辞書に入れやすくする 辞書保存量、ロード時間、メモリ使用量
学習サンプル設計 辞書に渡すレコード構成 URL構造、本文長、圧縮しにくいレコードの偏りを抑える 学習前処理、サンプル管理
学習パラメータ調整 サンプル数やtrainer条件 保存形式を変えずに辞書の中身を調整する 再現性管理、build時間
安定性診断 要求辞書サイズと実辞書サイズのズレ、クラスタ数 圧縮率だけが良い不安定な候補を避ける 診断値の記録と判定ロジック

Large Dictionary は、辞書ファイルを大きくするだけでは効果が安定しにくい場合があります。大きくした容量に保存量へ効くパターンを入れるため、学習サンプル設計と組み合わせて評価します。

学習サンプル設計では、URL 構造、本文長、訓練データ上での圧縮しにくさを使って、辞書に渡すレコードの代表性を整えます。これは読み込み時に多数の辞書を切り替えるためではありません。単一または少数の共有辞書を維持したまま、辞書に入る素材の偏りを抑えるための設計です。

チューニング手法の比較

チューニング候補は、共有辞書をどの程度の保存量で償却できるかによって採用しやすさが変わります。小さな保存量に対して大きな辞書を使うと、アーカイブ本体サイズ比が良くても、辞書込み実効サイズ比では不利になる場合があります。

次の表は、償却対象データ量ごとに、サイト辞書とチューニング候補の辞書込み実効サイズ比を比較したものです。

ケース 償却対象データ量 サイト辞書 実効サイズ比 チューニング候補 実効サイズ比 チューニング候補 共有辞書サイズ
Site A 1GiB 9.112% 8.467% 6.25 MiB
Site A 8GiB 9.026% 7.819% 22.99 MiB
Site A 16GiB 9.020% 7.689% 22.99 MiB
Site B 1GiB 15.181% 14.251% 6.25 MiB
Site B 8GiB 15.095% 13.310% 20.96 MiB
Site B 16GiB 15.089% 13.191% 20.96 MiB
Site C 1GiB 10.659% 9.952% 6.25 MiB
Site C 8GiB 10.446% 9.540% 30.43 MiB
Site C 16GiB 10.430% 9.317% 80.00 MiB

チューニング候補のアーカイブ本体サイズ比と共有辞書サイズは次のとおりです。

ケース 償却対象データ量 アーカイブ本体サイズ比 辞書込み実効サイズ比 共有辞書サイズ
Site A 1GiB 7.618% 8.467% 6.25 MiB
Site A 8GiB 7.394% 7.819% 22.99 MiB
Site A 16GiB 7.394% 7.689% 22.99 MiB
Site B 1GiB 13.665% 14.251% 6.25 MiB
Site B 8GiB 12.908% 13.310% 20.96 MiB
Site B 16GiB 12.908% 13.191% 20.96 MiB
Site C 1GiB 9.803% 9.952% 6.25 MiB
Site C 8GiB 9.327% 9.540% 30.43 MiB
Site C 16GiB 8.963% 9.317% 80.00 MiB

同じアーカイブ本体サイズ比の行で、辞書込み実効サイズ比だけが変わる場合があります。これは同じ候補を選んでいても、共有辞書を負担する保存量が大きくなることで、評価データあたりの辞書コストが小さくなるためです。一方で、Site C の 16GiB では、より大きな辞書を使う候補のほうが実効保存量を下げています。

自動辞書トレーニングの診断とガードレール

辞書は、学習データを渡せば常に意図どおりのサイズと性質で得られるわけではありません。今回の検証では、要求した辞書サイズと実際に生成された辞書サイズのズレを診断値として扱いました。

大きめの辞書サイズを要求しても、trainer が返す実際の辞書が大きく下回る場合があります。この状態を単純に失敗とみなす必要はありませんが、圧縮率が伸びず、かつ実際の辞書サイズが要求サイズに対して極端に小さい場合は、不安定な候補として扱います。

診断では、次の値を記録します。

診断値 目的
要求辞書サイズ trainer に要求した辞書サイズ
実辞書サイズ 実際に生成された辞書サイズ
実辞書サイズ / 要求辞書サイズ 要求に対して辞書がどの程度作られたか
学習サンプル数 辞書学習に使ったレコード数
学習データの総バイト数 辞書学習に使ったデータ量
縮退フラグ 辞書が不安定な状態に見える候補を識別するためのフラグ

この検証では、実辞書サイズが要求辞書サイズの 25% 未満で、性能も良くなく、学習データ量に対して辞書が十分に形成されていない候補を、不安定な点として扱う方針にしました。不安定な点は即座に失格にするのではなく、同等性能の安定した候補があれば選ばない、という扱いです。

また、クラスタ型の候補では、学習されたクラスタ数や代替扱いになったクラスタ数も見ます。候補の圧縮率が良く見えても、解釈可能なクラスタ構造がほとんど残っていない場合は、運用に載せる候補としては扱いにくくなります。

候補選定では、圧縮後サイズだけでなく、次の観点も合わせて見ます。

観点 採用方針
圧縮後サイズ 最小値から一定範囲内なら同等候補として扱う
build 時間 同等候補では短いものを優先する
辞書や補助成果物のサイズ 同等候補では小さいものを優先する
実辞書サイズの安定性 実辞書サイズが極端に崩れていないものを優先する
構造の解釈可能性 クラスタ数などが極端に潰れていないものを優先する

この方針は、保存量の最小化だけを追うよりも保守的です。ただし、長期保存のアーカイブでは、わずかな圧縮率差より、再現性、展開可能性、運用時の説明しやすさが重要になる場面があります。

Appendix: チューニング手法の具体例

ここからは、チューニング手法を疑似コードで整理します。実行可能な Python コードではなく、方式ごとに何を変えているかを説明するためのものです。実際の保存形式では、圧縮データに加えて、復元に必要な辞書 ID や辞書世代もメタデータとして保存します。

normalize_route、sample_quota、train_dictionary_with_options などは抽象化した補助関数です。実装では、サイトの URL 体系、本文長の分布、保存対象の読み込みパターンに合わせて定義します。

標準方式は、各レコードをそのまま zstd で圧縮します。

import zstandard as zstd

LEVEL = 22
KiB = 1024
MiB = 1024 * KiB

SITE_DICTIONARY_SIZE = 256 * KiB
LARGE_DICTIONARY_SIZE = 2 * MiB


def compress_standard(records):
    compressor = zstd.ZstdCompressor(level=LEVEL)
    archive = []

    for record in records:
        payload = compressor.compress(record.body)
        archive.append({
            "record_id": record.id,
            "dictionary_id": None,
            "payload": payload,
        })

    return archive

上記の辞書サイズは説明用の例です。実運用では、保存量、辞書の共有コスト、読み込み時のメモリ使用量を見ながら決めます。

サイト単位辞書方式では、学習データからサイトごとの辞書を作り、保存対象レコードにはその辞書を適用します。

def train_site_dictionary(train_records):
    samples = [record.body for record in train_records]
    return zstd.train_dictionary(SITE_DICTIONARY_SIZE, samples)


def compress_with_site_dictionary(site_id, train_records, records):
    dictionary = train_site_dictionary(train_records)
    compressor = zstd.ZstdCompressor(level=LEVEL, dict_data=dictionary)
    dictionary_id = f"{site_id}:site:v1"

    archive = []
    for record in records:
        payload = compressor.compress(record.body)
        archive.append({
            "record_id": record.id,
            "dictionary_id": dictionary_id,
            "payload": payload,
        })

    return archive

学習サンプル設計では、辞書に渡すレコードをそのまま全件並べるのではなく、URL 構造、本文長、訓練データ上での圧縮しにくさを使って代表性を整えます。bucket は辞書を分けるためではなく、学習サンプルを偏らせないために使います。

def select_dictionary_samples(train_records):
    buckets = {}

    for record in train_records:
        route = normalize_route(record.url)
        length = length_bucket(len(record.body))
        hardness = standard_compression_ratio(record.body)
        key = (route, length, hardness_bucket(hardness))
        add_record_to_bucket(buckets, key, record)

    samples = []
    for key, records in buckets.items():
        quota = sample_quota(
            bucket_key=key,
            record_count=len(records),
            raw_bytes=sum(len(record.body) for record in records),
        )
        samples.extend(sample_records(records, quota))

    samples = rebalance_by_raw_bytes(samples)
    samples = deduplicate_near_identical_samples(samples)
    return samples

辞書学習パラメータ調整では、同じ保存形式のまま、辞書サイズ、学習に使うサンプル数、trainer 条件の組み合わせを変えます。辞書は学習データから作り、候補選定用のサンプルでアーカイブ本体サイズ比を比較します。

def train_dictionary_candidates(samples):
    training_plans = [
        {
            "name": "site-sized",
            "dictionary_size": SITE_DICTIONARY_SIZE,
            "sample_limit": 2_000,
            "trainer_options": {"search": "standard"},
        },
        {
            "name": "large-balanced",
            "dictionary_size": LARGE_DICTIONARY_SIZE,
            "sample_limit": 8_000,
            "trainer_options": {"search": "wide"},
        },
    ]

    candidates = []
    for plan in training_plans:
        selected = limit_samples(samples, plan["sample_limit"])
        dictionary = train_dictionary_with_options(
            dictionary_size=plan["dictionary_size"],
            samples=[record.body for record in selected],
            trainer_options=plan["trainer_options"],
        )
        candidates.append({
            "name": plan["name"],
            "dictionary": dictionary,
            "dictionary_size": plan["dictionary_size"],
            "trainer_options": plan["trainer_options"],
        })

    return candidates

Large Dictionary は、基本構造はサイト単位辞書方式と同じですが、辞書容量を大きく取り、上記のサンプル設計と学習条件の調整を組み合わせます。圧縮時に使う辞書は、サイト単位または少数の大きな辞書のままです。

def train_shared_dictionary(train_records, selection_records):
    samples = select_dictionary_samples(train_records)
    candidates = train_dictionary_candidates(samples)

    best = choose_smallest_stable_candidate(
        candidates,
        selection_records,
    )

    return best["dictionary"]


def compress_with_shared_dictionary(site_id, dictionary, records):
    compressor = zstd.ZstdCompressor(level=LEVEL, dict_data=dictionary)
    dictionary_id = f"{site_id}:large:v1"

    archive = []
    for record in records:
        payload = compressor.compress(record.body)
        archive.append({
            "record_id": record.id,
            "dictionary_id": dictionary_id,
            "payload": payload,
        })

    return archive

候補選定では、圧縮後サイズだけでなく、辞書の安定性も見ます。

def choose_smallest_stable_candidate(candidates, selection_records):
    measurements = []

    for candidate in candidates:
        compressed_bytes = replay_on_selection_sample(
            candidate["dictionary"],
            selection_records,
        )
        diagnostics = inspect_dictionary_training(candidate)
        measurements.append({
            "candidate": candidate,
            "compressed_bytes": compressed_bytes,
            "actual_dictionary_size": diagnostics.actual_dictionary_size,
            "requested_dictionary_size": diagnostics.requested_dictionary_size,
            "build_seconds": diagnostics.build_seconds,
            "artifact_bytes": diagnostics.artifact_bytes,
            "is_unstable": diagnostics.is_unstable,
        })

    best_bytes = min(row["compressed_bytes"] for row in measurements)
    tie_threshold = max(32, best_bytes * 0.005)

    comparable = [
        row
        for row in measurements
        if row["compressed_bytes"] <= best_bytes + tie_threshold
    ]
    stable = [row for row in comparable if not row["is_unstable"]]
    pool = stable if stable else comparable

    return min(
        pool,
        key=lambda row: (
            row["artifact_bytes"],
            row["build_seconds"],
            row["actual_dictionary_size"],
        ),
    )["candidate"]

この疑似コードの要点は、最小の圧縮後サイズを出した候補を常に採用するわけではないことです。差が小さい場合は、辞書サイズ、build 時間、実辞書サイズの安定性を見て、長期運用しやすい候補を選びます。

まとめ

今回のデータでは、zstd の共有辞書によって保存量の低下が確認できました。元データを 100% とすると、標準方式のアーカイブ本体サイズ比は 14.011〜32.554%、サイト辞書のアーカイブ本体サイズ比は 9.014〜15.083% でした。

辞書込み実効サイズ比で見ると、サイト辞書は 1GiB で 9.112〜15.181%、8GiB で 9.026〜15.095%、16GiB で 9.020〜15.089% でした。さらに共有辞書をチューニングすると、1GiB で 8.467〜14.251%、8GiB で 7.819〜13.310%、16GiB で 7.689〜13.191% になりました。

共有辞書方式は、保存量を下げる余地がある一方で、辞書 ID、辞書世代、辞書キャッシュ、再学習、欠損時の復元手順を設計に含める必要があります。また、自動辞書トレーニングでは、要求辞書サイズと実辞書サイズのズレや、学習結果の縮退を診断し、同等性能なら安定した候補を選ぶほうが運用しやすくなります。

圧縮率の改善、辞書込みの実効保存量、読み込みワークロードへの影響を同じ判断材料として扱うことが、クローラーの長期保存形式では重要です。
ルーティングテーブルだけでは届かなかった DNS: Tailscale subnet router 越しに Kubernetes worker node を足した話

これはなに

自宅 Kubernetes に worker node を1台追加したときのメモ。

既存の Kubernetes node は server network 側、追加した worker は別 network 側にあった。

Tailscale の subnet router を使って site-to-site networking 的につなぎ、routing table を設定した。 node は Ready になる。RKE2 agent も起動する。API server にもつながる。

しかし、Pod から DNS が引けなかった…。

nslookup kubernetes.default.svc.cluster.local 10.96.0.10
;; connection timed out; no servers could be reached

最終的には、route でも Tailscale ACL でも kube-proxy でもなく、通信経路は正しく設定できているが、flannel.1 の checksum offload に問題があることが判明した。

sudo ethtool -K flannel.1 tx-checksum-ip-generic off

これで直った。

ただし、そこにたどり着くまでにかなり遠回りした。せっかくなので、どうトラブルシュートしたかをまとめておく。

構成

ざっくりこういう構成。

Network topology with example IP ranges

router-01
  LAN gateway:        192.0.2.1/24
  server gateway:     198.51.100.1/24
  interconnect gw:    203.0.113.1/24

└── switch-01
    ├── server / Kubernetes underlay segment
    │   network:      198.51.100.0/24
    │   pod CIDR:     10.244.0.0/16
    │   service CIDR: 10.96.0.0/12
    │
    │   └── hypervisor-a / Proxmox
    │       ├── cp-01            198.51.100.11    podCIDR 10.244.0.0/24
    │       ├── cp-02            198.51.100.12    podCIDR 10.244.1.0/24
    │       ├── cp-03            198.51.100.13    podCIDR 10.244.3.0/24
    │       ├── worker-01        198.51.100.21    podCIDR 10.244.4.0/24
    │       ├── worker-02        198.51.100.22    podCIDR 10.244.5.0/24
    │       ├── worker-03        198.51.100.23    podCIDR 10.244.6.0/24
    │       └── site-router-01
    │           home-side:       192.0.2.15
    │           server-side:     198.51.100.30
    │           Tailscale IP:    100.64.10.15
    │
    └────  2.5GbE hub
             └── edge-host-01 / VMware
                 └── edge-worker-01
                     home-side:       192.0.2.14
                     Tailscale IP:    100.64.10.14
                     podCIDR:         10.244.2.0/24

Kubernetes 側は RKE2。CNI は Canal なので、Pod-to-Pod networking は Flannel VXLAN、NetworkPolicy まわりは Calico という構成になる。

edge-worker-01 は 192.0.2.1/24 側にいるので、198.51.100.0/28 や 198.51.100.16/28 へ出るには site-router-01 を next hop にする。

ip route replace 198.51.100.0/28 via 192.0.2.15 dev ens32 src 192.0.2.14
ip route replace 198.51.100.16/28 via 192.0.2.15 dev ens32 src 192.0.2.14

反対側、つまり server network 側の node から 192.0.2.14 へ戻る route も必要になる。

ip route replace 192.0.2.14/32 via 198.51.100.253

ここまでで host level の通信は動く。edge-worker-01 は cluster に join するし、kubectl get nodes でも Ready になる。

しかし Pod から DNS は引けない。

まず route と ACL を疑う

最初に疑ったのは Tailscale の subnet route と ACL。

今回の構成では Tailscale の subnet router で site-to-site networking をしていた。

Tailscale の subnet router は、tailnet と物理 subnet の間に置く gateway として使うもので、Tailscale を直接入れていない機器や network にも到達できるようになる。

基本的な考え方はこのあたり。

https://tailscale.com/docs/features/subnet-routers https://tailscale.com/docs/features/site-to-site

この時点では、「Kubernetes の制御通信は通るけど Pod DNS は通らない」という現象を見て、Tailscale policy file の書き方が悪いのでは、と思っていた。

なので ACL を整理した。Kubernetes control plane と Flannel VXLAN を同じものとして扱わないようにした。

/* K8S flannel VXLAN overlay */
{
  "action": "accept",
  "src": ["ipset:k8s-vxlan-home-client-01s"],
  "proto": "udp",
  "dst": ["ipset:k8s-vxlan-native-peers:8472"]
},
{
  "action": "accept",
  "src": ["ipset:k8s-vxlan-native-peers"],
  "proto": "udp",
  "dst": ["ipset:k8s-vxlan-home-client-01s:8472"]
}

control plane 側は別にする。

/* K8S control plane / kubelet */
{
  "action": "accept",
  "src": ["edge-worker-01-home"],
  "dst": ["ipset:k8s-control-plane-native:6443,9345"]
},
{
  "action": "accept",
  "src": ["ipset:k8s-control-plane-native"],
  "dst": ["edge-worker-01-home:10250"]
}

わかりやすくなったのでこの整理自体は良かったが、これで直ったわけではない。

Service ではなく Pod-to-Pod networking を見る

確認用 Pod を edge-worker-01 に固定して、Service VIP と CoreDNS Pod IP の両方を直接引いてみる。 Service VIP だけを見ると kube-proxy や Service 周りの問題と混ざるので、CoreDNS の Pod IP も指定する。これで、Service ClusterIP の問題なのか、Pod-to-Pod の overlay network の問題なのかを分けられる。

POD="edge-worker-dnscheck-$(date +%s)"
NS="debug-jobs"
NODE="edge-worker-01"

printf '%s\n' \
'apiVersion: v1' \
'kind: Pod' \
'metadata:' \
"  name: ${POD}" \
"  namespace: ${NS}" \
'spec:' \
"  nodeName: ${NODE}" \
'  restartPolicy: Never' \
'  containers:' \
'    - name: dnscheck' \
'      image: busybox:1.36.1' \
'      command:' \
'        - sh' \
'        - -c' \
'        - |' \
'          set -x' \
'          date -u' \
'          cat /etc/resolv.conf' \
'          nslookup kubernetes.default.svc.cluster.local 10.96.0.10' \
'          nslookup kubernetes.default.svc.cluster.local 10.244.0.11' \
'          nslookup kubernetes.default.svc.cluster.local 10.244.3.37' \
'          nslookup example.com 10.96.0.10' \
| kubectl apply -f -

for i in $(seq 1 60); do
  PHASE="$(
    kubectl -n "${NS}" get pod "${POD}" \
      -o jsonpath='{.status.phase}' 2>/dev/null || true
  )"

  echo "phase=${PHASE}"

  if [ "${PHASE}" = "Succeeded" ] || [ "${PHASE}" = "Failed" ]; then
    break
  fi

  sleep 1
done

kubectl -n "${NS}" get pod "${POD}" -o wide
kubectl -n "${NS}" logs "${POD}" --timestamps
kubectl -n "${NS}" delete pod "${POD}" --wait=false

10.96.0.10 は CoreDNS の Service ClusterIP。10.244.0.11 と 10.244.3.37 は CoreDNS の実 Pod IP。

結果は全部 timeout。

Service ClusterIP だけ落ちるなら kube-proxy を見る。しかし CoreDNS Pod IP を直接指定しても落ちるので、Service proxy ではなく Pod-to-Pod networking の問題と見てよい。

RKE2 の要件にも、Flannel VXLAN を使う場合は node 間で UDP/8472 が通る必要がある、とある。

https://docs.rke2.io/install/requirements

つまり edge-worker-01 と cp-01/02 の間で、Flannel VXLAN の outer packet が通っているかを見る必要がある。

flannel がどの IP を使っているか

kubectl get nodes の annotation で、Flannel の public-ip と podCIDR を見る。

kubectl get nodes -o jsonpath='{range .items[*]}{.metadata.name}{"\t"}{.metadata.annotations.flannel\.alpha\.coreos\.com/public-ip}{"\t"}{.spec.podCIDR}{"\n"}{end}'

整理するとこうだった。

cp-01            flannel public-ip=198.51.100.11   podCIDR=10.244.0.0/24
cp-03            flannel public-ip=198.51.100.13   podCIDR=10.244.3.0/24
edge-worker-01   flannel public-ip=192.0.2.14      podCIDR=10.244.2.0/24

次に、control plane 側で edge-worker-01 の PodCIDR がどこへ向いているかを見る。

ip route | grep '10.244.2.0/24'
sudo bridge fdb show dev flannel.1 | grep '192\.0\.2\.14'
10.244.2.0/24 via 10.244.2.0 dev flannel.1 onlink
02:00:4d:d0:35:00 dst 192.0.2.14 self permanent

つまり、10.244.2.0/24 宛の traffic は flannel.1 に入り、VXLAN の outer destination として 192.0.2.14 が使われる。

raw UDP は通る

次に UDP/8472 自体が通るかを確認した。

master 側から edge-worker に向けて短い UDP packet を投げたり、その逆を試した。tcpdump で site-router-01 の ens18 / ens20 と、master 側の ens18 を見る。

raw UDP は通った。戻り方向も通った。

これは重要で、少なくとも次の仮説はかなり弱くなった。

  • route が全面的におかしい
  • site-router-01 の forwarding が死んでいる
  • Proxmox bridge が単純に UDP/8472 を落としている
  • INPUT chain で UDP/8472 が単純に落ちている
  • Tailscale ACL で落ちている

ところが、Pod DNS はまだ落ちる。

この時点で「UDP/8472 が通るなら Flannel VXLAN も通るはず」と考えたくなるが、そうではなかった。raw UDP と Flannel が生成する正規の VXLAN frame は違う。

raw UDP test は tcpdump ではこう見えた。

OTV, flags [.] (0x76), overlay 7892065, instance 7220592

一方、Flannel VXLAN はこう見える。

OTV, flags [I] (0x08), overlay 0, instance 1

tcpdump が OTV と表示しているのはさておき、見るべきは flags [I] と instance 1 のほう。

本物の VXLAN packet を見る

edge-worker-01 上で tcpdump する。

sudo tcpdump -tttt -vvv -nni ens32 \
  'udp dst port 8472 and src host 192.0.2.14 and (dst host 198.51.100.11 or dst host 198.51.100.13)'

Pod から CoreDNS に問い合わせると、こういう packet が出る。

192.0.2.14.64625 > 198.51.100.11.8472: [bad udp cksum ...]
OTV, flags [I] (0x08), overlay 0, instance 1
IP 10.244.2.58 > 10.244.0.11.53: A? kubernetes.default.svc.cluster.local.

198.51.100.13 / 10.244.3.37 宛も同じように出る。

site-router-01 の ens18 でも見える。ens20 でも見える。つまり、edge-worker から出た正規 VXLAN packet は subnet router を通過している。

ところが master 側では、同じ条件で 0 packets だった。

sudo tcpdump -tttt -vvv -nni ens18 \
  'udp dst port 8472 and src host 192.0.2.14 and dst host 198.51.100.11'
0 packets captured

raw UDP は見えるのに、Flannel の正規 VXLAN は見えない。

この時点でだいぶ嫌な予感がしてくる。route ではない。ACL でもない。packet の種類によって挙動が違う。

ログに出ている bad udp cksum を疑うことにした。

bad udp cksum と checksum offload

送信側の tcpdump で bad udp cksum が出るのは、それだけならよくある。NIC の checksum offload が有効な場合、tcpdump は checksum がまだ完成していない packet を見ることがある。

しかし今回は、edge-worker だけではなく、site-router-01 の ens18 / ens20 でも bad udp cksum が見えていた。raw UDP は通るが、正規の Flannel VXLAN だけが落ちる。しかも DNS は完全に timeout する。

このへんは自分だけで見ていたら、たぶん route と firewall を延々といじっていた気がする。AI に「raw UDP は通るが正規 VXLAN だけ落ちる」という形で投げたら、checksum/offload の線がかなり濃いという返しになった。正直ここでようやく flannel.1 側を疑う発想になった。

Flannel の troubleshooting にもこの回避策がある。

https://github.com/flannel-io/flannel/blob/master/Documentation/troubleshooting.md

VMware と Flannel の組み合わせで flannel.1 の checksum offload を切る話も出てくる。

https://community.replicated.com/t/flannel-with-vmware/1396

直す

edge-worker-01 でこれを実行する。

sudo ethtool -k flannel.1 | grep -E 'tx-checksum|tx-checksum-ip-generic|tcp-segmentation|generic-segmentation'
sudo ethtool -K flannel.1 tx-checksum-ip-generic off
sudo ethtool -k flannel.1 | grep -E 'tx-checksum|tx-checksum-ip-generic|tcp-segmentation|generic-segmentation'

実行前はこう。

tx-checksumming: on
  tx-checksum-ip-generic: on

実行後はこう。

Actual changes:
tx-checksum-ip-generic: off
tx-tcp-segmentation: off [not requested]
...
tx-checksumming: off
  tx-checksum-ip-generic: off

その後、同じ DNS check を再実行する。

nslookup kubernetes.default.svc.cluster.local 10.96.0.10
nslookup kubernetes.default.svc.cluster.local 10.244.0.11
nslookup kubernetes.default.svc.cluster.local 10.244.3.37
nslookup artifact-bucket.example.com 10.96.0.10

今度は全部通った。

Server: 10.96.0.10
Name: kubernetes.default.svc.cluster.local
Address: 10.96.0.1

Server: 10.244.0.11
Name: kubernetes.default.svc.cluster.local
Address: 10.96.0.1

Server: 10.244.3.37
Name: kubernetes.default.svc.cluster.local
Address: 10.96.0.1

外部名も引ける。

artifact-bucket.example.com canonical name = object-storage.example.net

phase=Succeeded になった。これで今回の DNS 問題は直った。

永続化

flannel.1 は Canal/flannel によって作られる interface なので、単に boot 時に一回叩けばOKとは限らない。interface 作成時にも適用されるようにしておく。

edge-worker-01 に script を置く。

sudo tee /usr/local/sbin/disable-flannel1-tx-checksum.sh >/dev/null <<'SCRIPT'
#!/bin/sh
set -eu

if ip link show flannel.1 >/dev/null 2>&1; then
  /usr/sbin/ethtool -K flannel.1 tx-checksum-ip-generic off
fi
SCRIPT

sudo chmod +x /usr/local/sbin/disable-flannel1-tx-checksum.sh

udev rule。

sudo tee /etc/udev/rules.d/90-flannel1-tx-checksum.rules >/dev/null <<'RULE'
SUBSYSTEM=="net", ACTION=="add|change|move", KERNEL=="flannel.1", RUN+="/usr/local/sbin/disable-flannel1-tx-checksum.sh"
RULE

sudo udevadm control --reload

保険で systemd service も置く。

sudo tee /etc/systemd/system/disable-flannel1-tx-checksum.service >/dev/null <<'UNIT'
[Unit]
Description=Disable tx-checksum-ip-generic on flannel.1
After=network-online.target rke2-agent.service
Wants=network-online.target

[Service]
Type=oneshot
ExecStart=/bin/sh -c 'for i in $(seq 1 60); do if ip link show flannel.1 >/dev/null 2>&1; then exec /usr/local/sbin/disable-flannel1-tx-checksum.sh; fi; sleep 1; done; exit 1'
RemainAfterExit=yes

[Install]
WantedBy=multi-user.target
UNIT

sudo systemctl daemon-reload
sudo systemctl enable --now disable-flannel1-tx-checksum.service

確認。

sudo ethtool -k flannel.1 | grep -E 'tx-checksumming|tx-checksum-ip-generic'

期待値。

tx-checksumming: off
  tx-checksum-ip-generic: off

わかったこと

今回の問題は、最初に見えていたより layer が多かった。

  • Tailscale subnet router による site-to-site routing
  • Linux の routing table / policy routing
  • RKE2 agent の join
  • Flannel VXLAN の UDP/8472
  • Calico の iptables/nftables rule
  • flannel.1 の checksum offload
  • VMware / Proxmox / 物理 network

このうち、最初に疑ったのは Tailscale ACL と route だった。確かにそこも重要だが、最終的な DNS timeout の直接原因はそこではなかった。

決め手になったのは、10.96.0.10 だけでなく CoreDNS Pod IP へ直接 timeout すること、raw UDP は通ること、正規の Flannel VXLAN だけ bad udp cksum 付きで落ちること、そして flannel.1 の tx-checksum-ip-generic を off にすると即座に DNS が通ることだった。

AI との壁打ちは、この手の layer 分けにはかなり便利だった。GPT 5.5 xhigh と 5.5 pro thinkingを使った。観測結果を貼っていくと「その仮説ならこの tcpdump とは矛盾する」という形で鬼ロジカルシンキング力で適切な方向にガイドしてくれた。

SSDで組んだアレイにTRIM設定を忘れたら自宅 Kubernetes が崩壊した話

ある日の朝起きると自宅 Kubernetes クラスタが崩壊していた。

症状としてはシンプルにKubernetes 上で動いてる多くのサービスに接続できない。

切り分けていくと Kubernetes の control plane を構成するノードが散発的にクラスタから外れていた。

根本的な原因は Proxmox ホスト側の I/O 詰まりで、ZFS プールに対して trim をかけることで事象が解消した。

自宅 K8S 環境

  • ハイパーバイザ: Proxmox VE 8.4
  • ホストストレージ:
    • OS用ストレージ: ZFS mirror (SATA SSD x3)
    • VM用ストレージ: ZFS dRAID2 (NVMe SSD x12; SATA SSD x2 for SLOG)
  • Kubernetes:
    • control plane 3 台
      • etcd は各 control plane 上で動作
  • VM ディスク:
    • ZFS 上の zvol

Kubernetes の control plane の VM が ZFS の zvol に乗っていて、その下に NVMe の dRAID プールがいる。

トラブルシュートで確認したこと

cpu/mem/io 負荷

CPU やメモリの負荷は平常レベルだが IO の負荷だけが高い。

/proc/pressure/io

  • host
some avg10=12.42 avg60=17.79 avg300=25.63
full avg10=11.89 avg60=17.11 avg300=24.70

ゲスト側はもっとひどい。

  • guest
some avg10=30.38 avg60=42.98 avg300=49.92
full avg10=23.72 avg60=35.67 avg300=41.33

etcdctl のヘルスステータス

etcdctl endpoint health --clusterのTOOK` と、ノードごとの health 状態。

ETCDCTL=/path/to/etcdctl

while true; do
  date -u
  sudo ETCDCTL_API=3 "$ETCDCTL" \
    --cacert=/path/to/server-ca.crt \
    --cert=/path/to/server-client.crt \
    --key=/path/to/server-client.key \
    --endpoints=https://127.0.0.1:2379 endpoint health --cluster -w table
  sleep 5
done

平常時は 10ms 前後で返る。

+------------------------+--------+-------------+
| ENDPOINT               | HEALTH | TOOK        |
+------------------------+--------+-------------+
| https://10.0.0.11:2379 | true   |  7.5ms      |
| https://10.0.0.12:2379 | true   |  7.7ms      |
| https://10.0.0.13:2379 | true   | 21.1ms      |
+------------------------+--------+-------------+

一方で、異常時はこうなる。

Fri Mar  6 10:17:41 UTC 2026
+------------------------+--------+--------------+--------------------------------+
| ENDPOINT               | HEALTH | TOOK         | ERROR                          |
+------------------------+--------+--------------+--------------------------------+
| https://10.0.0.11:2379 | true   | 994.107885ms |                                |
| https://10.0.0.12:2379 | true   | 2.805447218s |                                |
| https://10.0.0.13:2379 | false  | 4.275625994s | Unable to fetch the alarm list |
+------------------------+--------+--------------+--------------------------------+
Error: unhealthy cluster

通常は数 ms で返るのに、散発的に数百 ms、ひどいと数秒単位で止まる。

iommu=pt

Proxmoxのブートオプションに iommu=pt を追加して再起動した。チャッピーが試せって言うから…(特に効果なし)

ホストログに AMD-Vi: IO_PAGE_FAULT が何度か出ていたので、まずは IOMMU 周りを疑った。

ZFSへの trim 設定

次に iostat -x 1 と zpool iostat -v 1 を眺めた。

最初の採取では特定の NVMe だけが遅いようにも見えていた。
ただしより長期間のデータ全体としてはどのディスクでも一定確率で遅延が起きているように見えた。

たとえば ZFS の dRAID 配下では、各 NVMe へほぼ均等に書き込みが分散していた。

data  write 24.4M
  nvme0n1  2.03M
  nvme1n1  2.03M
  ...
  nvme11n1 2.03M

にも関わらず同時に iostat -x 1 の瞬間値では、あるタイミングで 1 本だけ突出して遅く見えることがあった。

Device   w/s   wkB/s  w_await aqu-sz %util
nvme7n1   59     580    62.56   5.49 89.10

この段階では、

  • どの M.2 ポートが悪いのか
  • どの PCI-Express バスが悪いのか
  • 特定スロットだけが悪いのか

を一発で断定できる感じではなかった。

ここまで見ていて、もしかして TRIM 周りでは、と思った。

SSDの特性上、TRIM が行われていないとかなりパフォーマンスが劣化するシーンがある。

長く使った SSD アレイで TRIM が走っていないなら、書き込みレイテンシが悪化してもおかしくない。

今回のVM用アレイを操作するレイヤーになる ZFS には autotrim と、明示的な zpool trim がある。手動 zpool trim は autotrim の on/off に関係なく実行できる。 (openzfs.github.io)

さらにその上のレイヤーでは Proxmox のディスクの discard がゲストからの TRIM/UNMAP を下位ストレージへ伝えるための設定で、thin provisioning や未使用領域の回収に効く。 (pve.proxmox.com)

実際に確認してみると、ZFS プールの autotrim は off だった…。

ZFS のプールを trim して事象解消

そこで data プールに対して trim を実行した。

zpool set autotrim=on data
zpool trim data

この後、ホストの load average がかなり下がった。

さらに /proc/pressure/io を見ると、以前とは別物レベルまで改善していた。

trim 前のホスト:

some avg10=12.42
full avg10=11.89

trim 後のホスト:

some avg10=0.34
full avg10=0.34

ゲスト側も同様に改善した。

guest-0 /proc/pressure/io
some avg10=1.78 avg60=1.21 avg300=1.80
full avg10=1.44 avg60=0.98 avg300=1.37

そして etcd も安定するようになった。

+------------------------+--------+-------------+
| ENDPOINT               | HEALTH | TOOK        |
+------------------------+--------+-------------+
| https://10.0.0.11:2379 | true   |  7.2ms      |
| https://10.0.0.12:2379 | true   |  6.4ms      |
| https://10.0.0.13:2379 | true   |  6.6ms      |
+------------------------+--------+-------------+

総括

  • SSDのTRIMを設定していないとIOが刺さって死ぬことがある